
Hoy voy a analizar el LattePanda Mu Ultra, un módulo de cómputo x86 compacto pensado para aplicaciones de IA en el propio dispositivo. Está disponible en dos versiones, con un procesador Intel Core Ultra 5 226V o un Core Ultra 7 256V. Ambos modelos incorporan 16 GB de memoria LPDDR5X de alta velocidad a 8533 MT/s, y el más potente alcanza hasta 115 TOPS de capacidad de cómputo de IA combinada.
Para este análisis he instalado Ubuntu 26.04 y he evaluado el LattePanda Mu Ultra con varias herramientas, como sbc-bench, Geekbench 7 y Geekbench AI. También he medido el rendimiento de su CPU, su GPU y su NPU con llama.cpp y YOLO26 para comprobar su valía en aplicaciones de IA. Por último, he creado una demostración bastante entretenida que combina YOLO26, MediaPipe y OpenCV para poner a prueba la visión por computador en tiempo real, incluidos ajustes de imagen controlados por gestos de la mano con una cámara web USB.
Desembalaje del LattePanda Mu Ultra
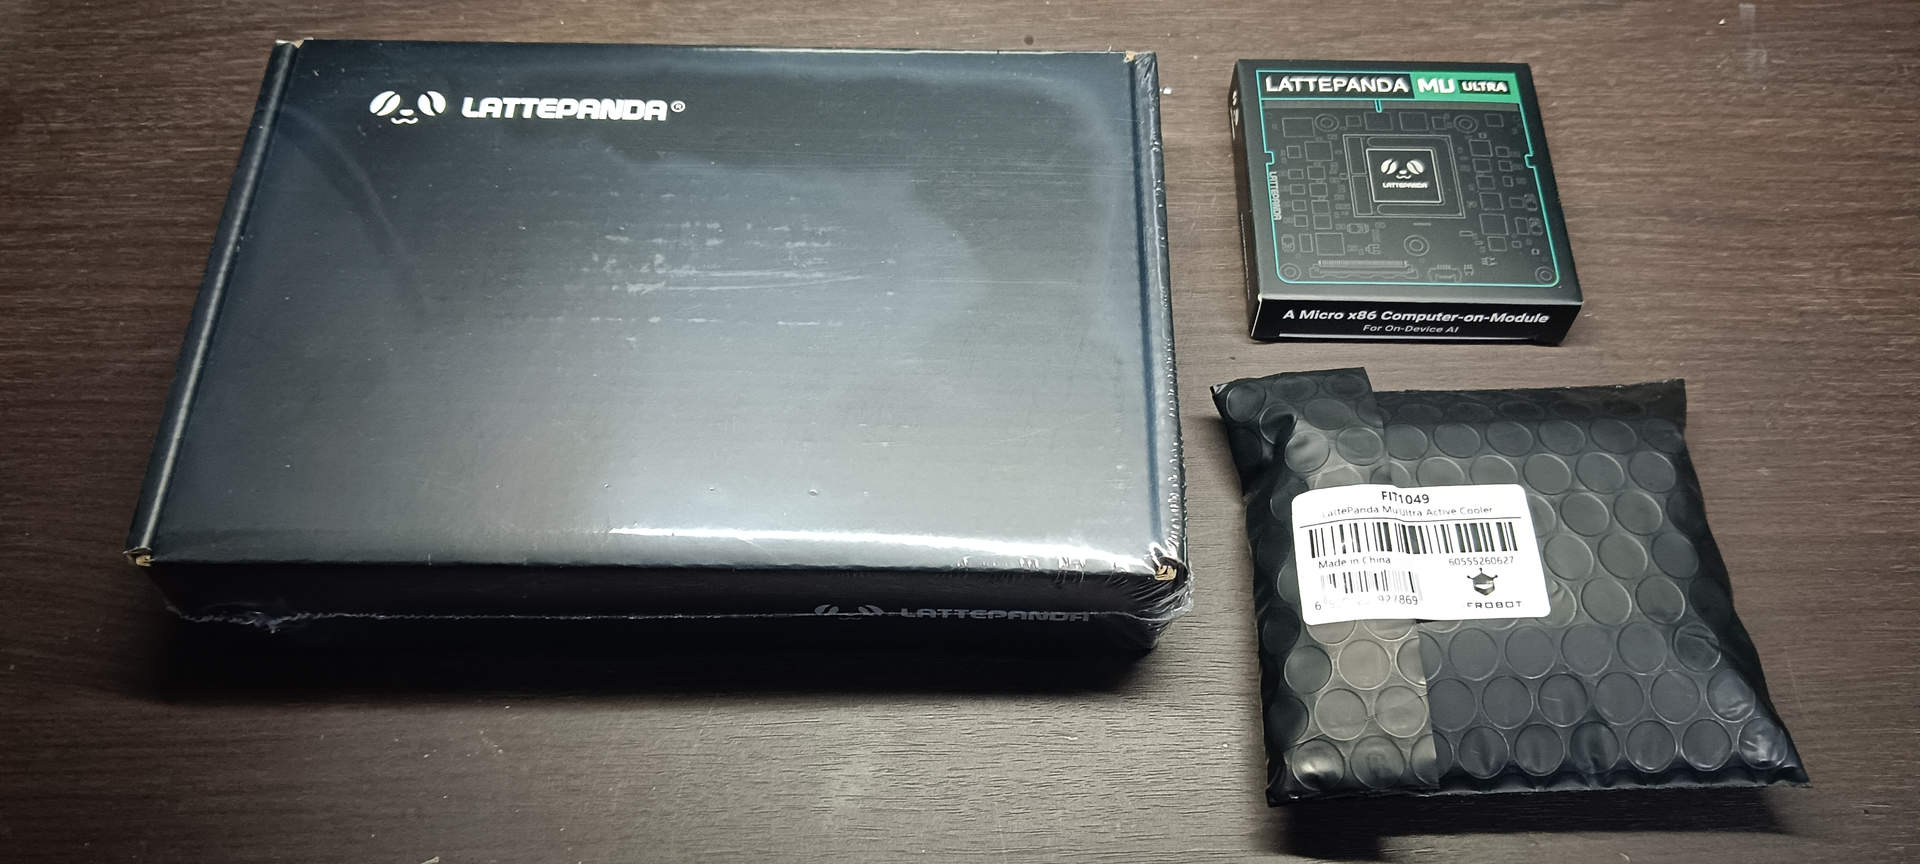
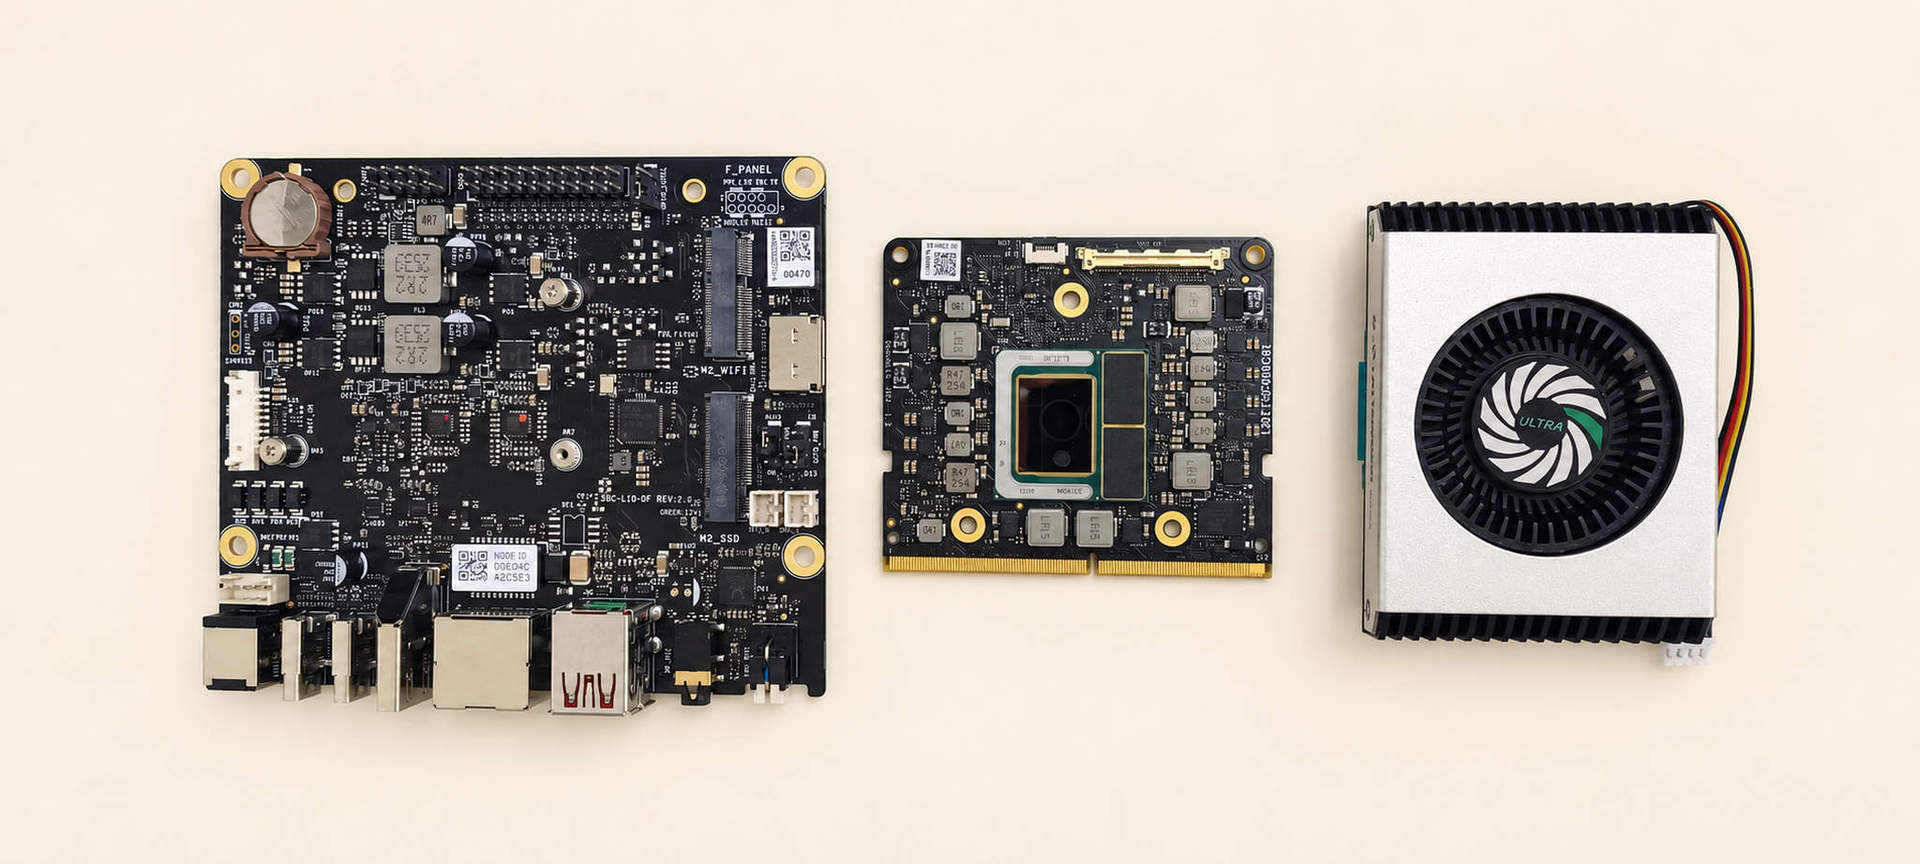
El paquete se envió desde China y llegó en unos cinco días. Todo venía en una caja de cartón estándar, con abundante espuma protectora para que los componentes no sufrieran daños durante el transporte. He recibido el modelo basado en el procesador Intel Core Ultra 7 256V. El fabricante también ha enviado la placa portadora Mini para LattePanda Mu y Mu Ultra, y el disipador activo de aluminio para el LattePanda Mu Ultra. Todo estaba bien embalado y llegó en buen estado, sin daños visibles, como se aprecia en la siguiente imagen.
Montaje del kit
Configuración inicial
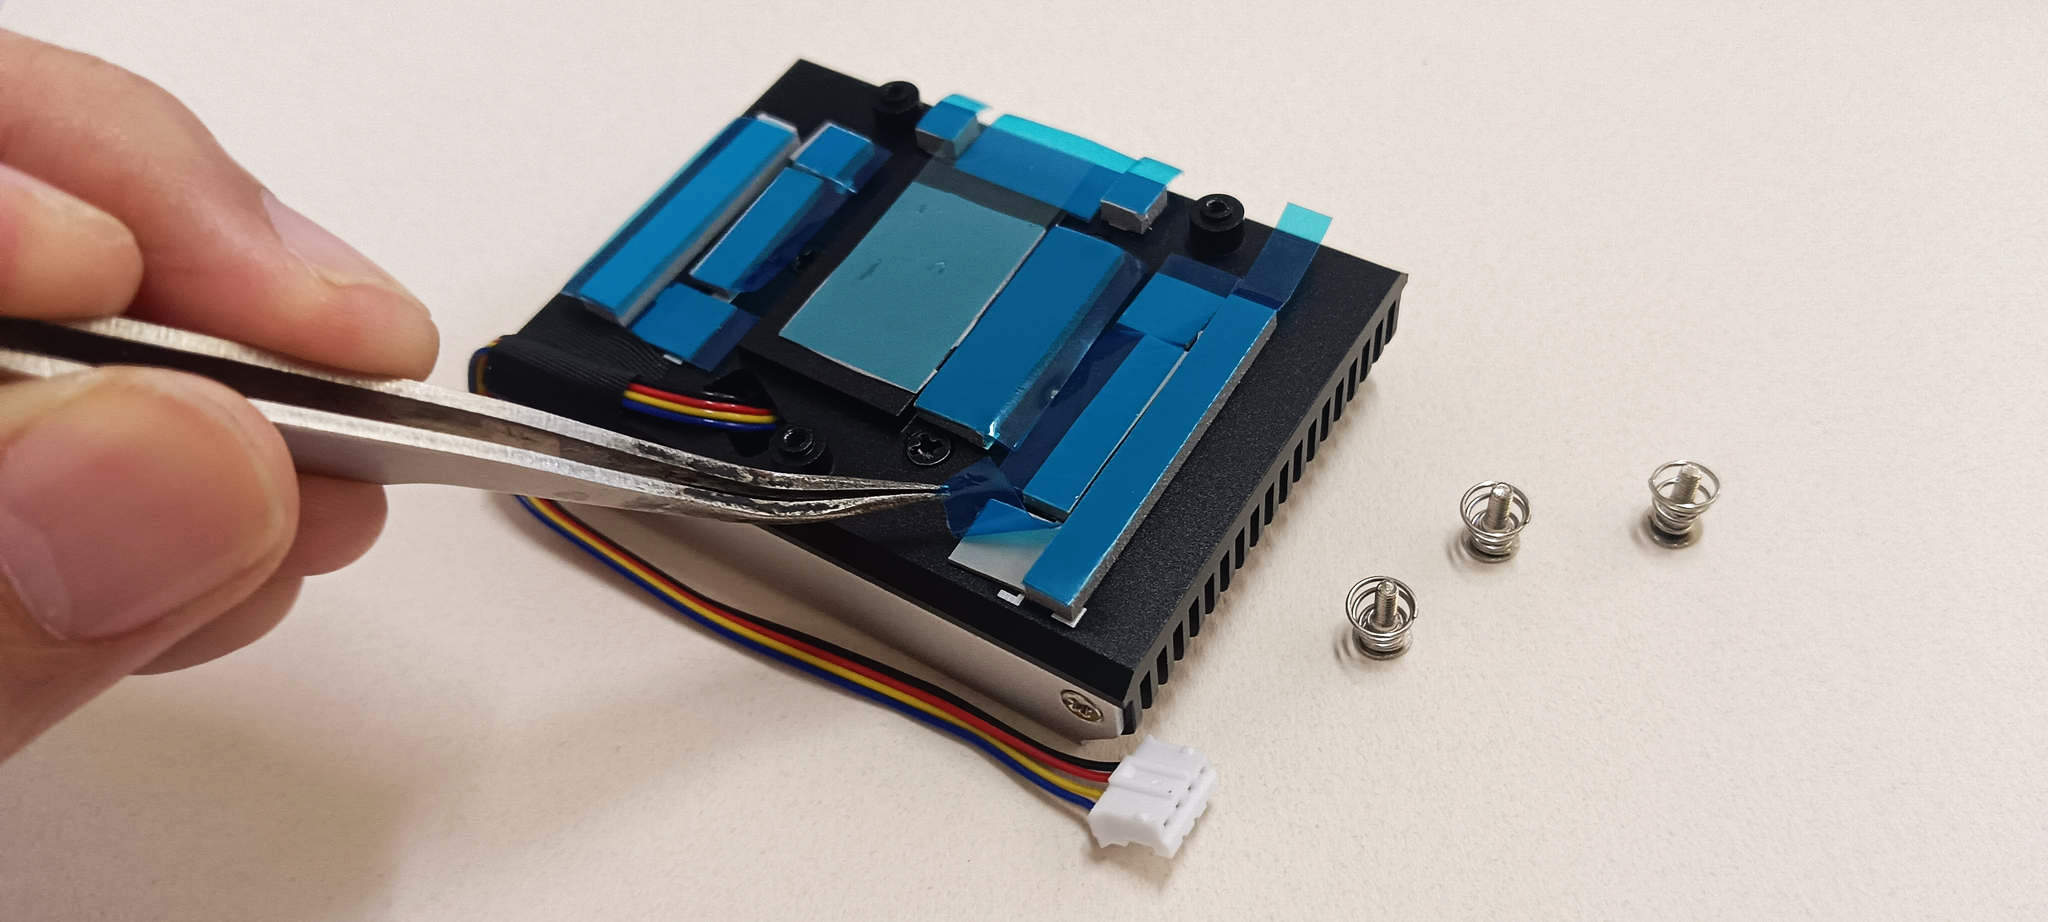
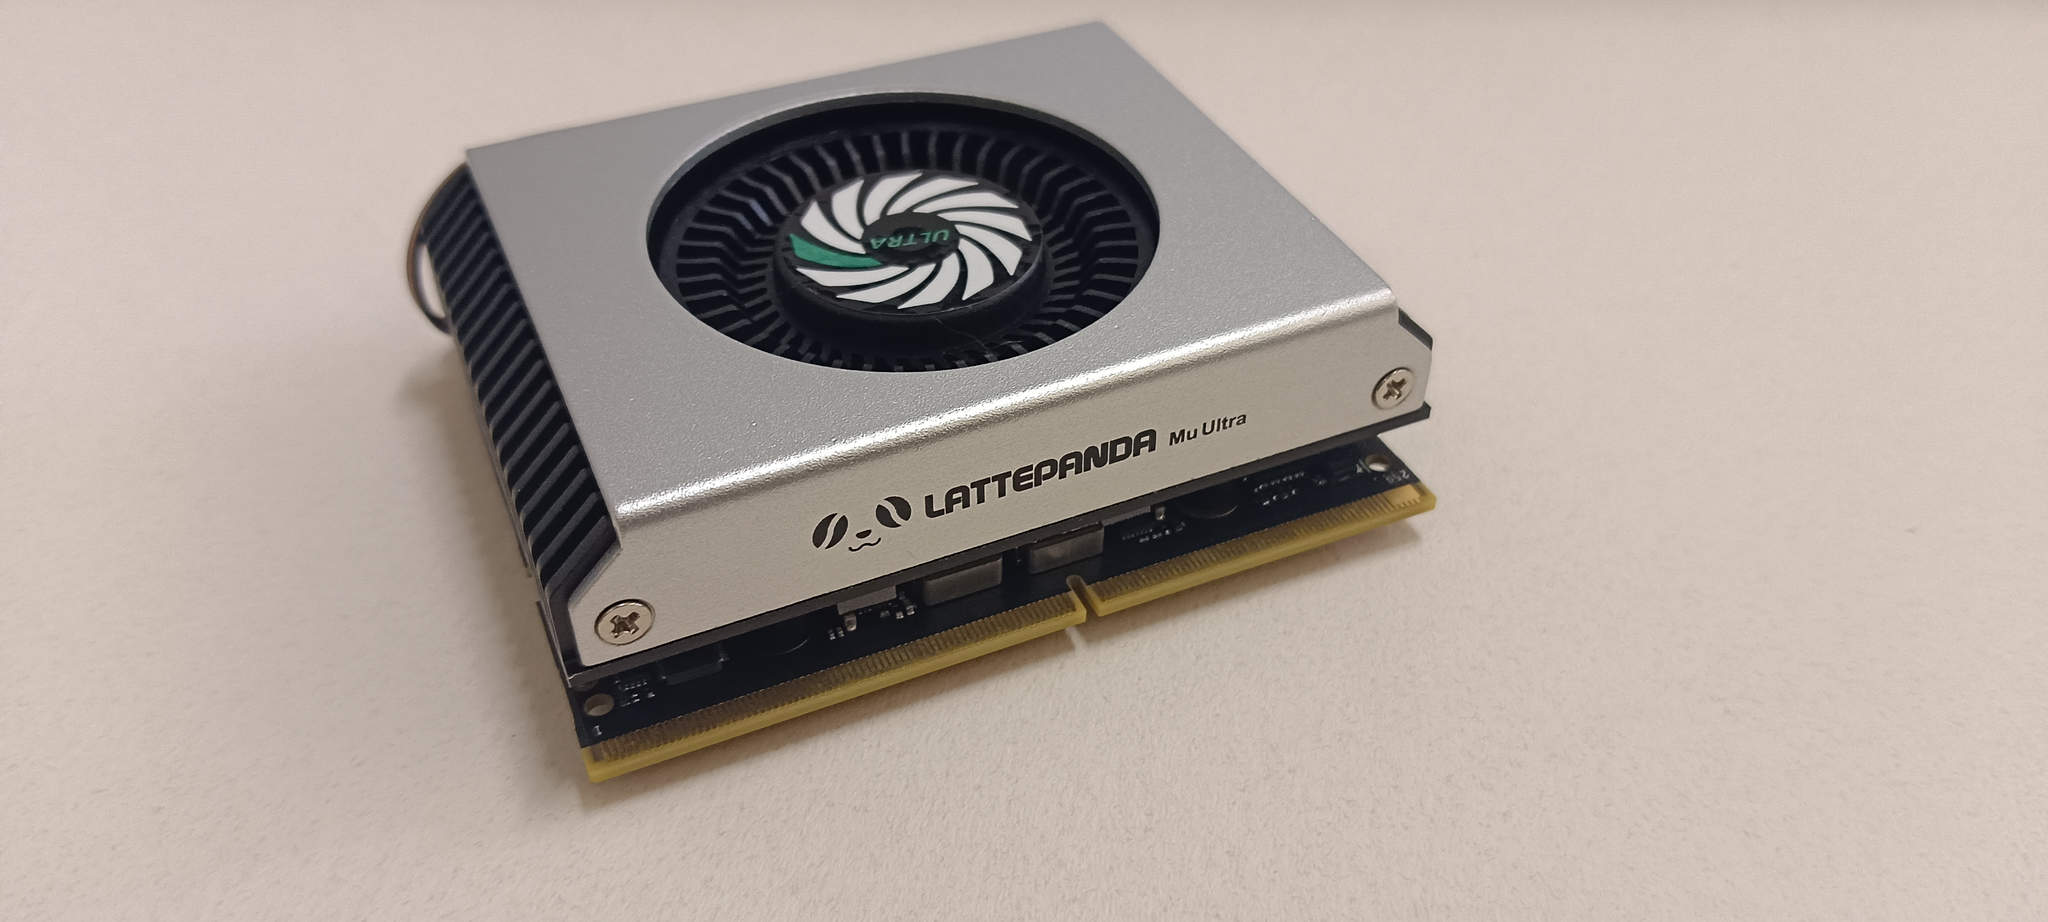
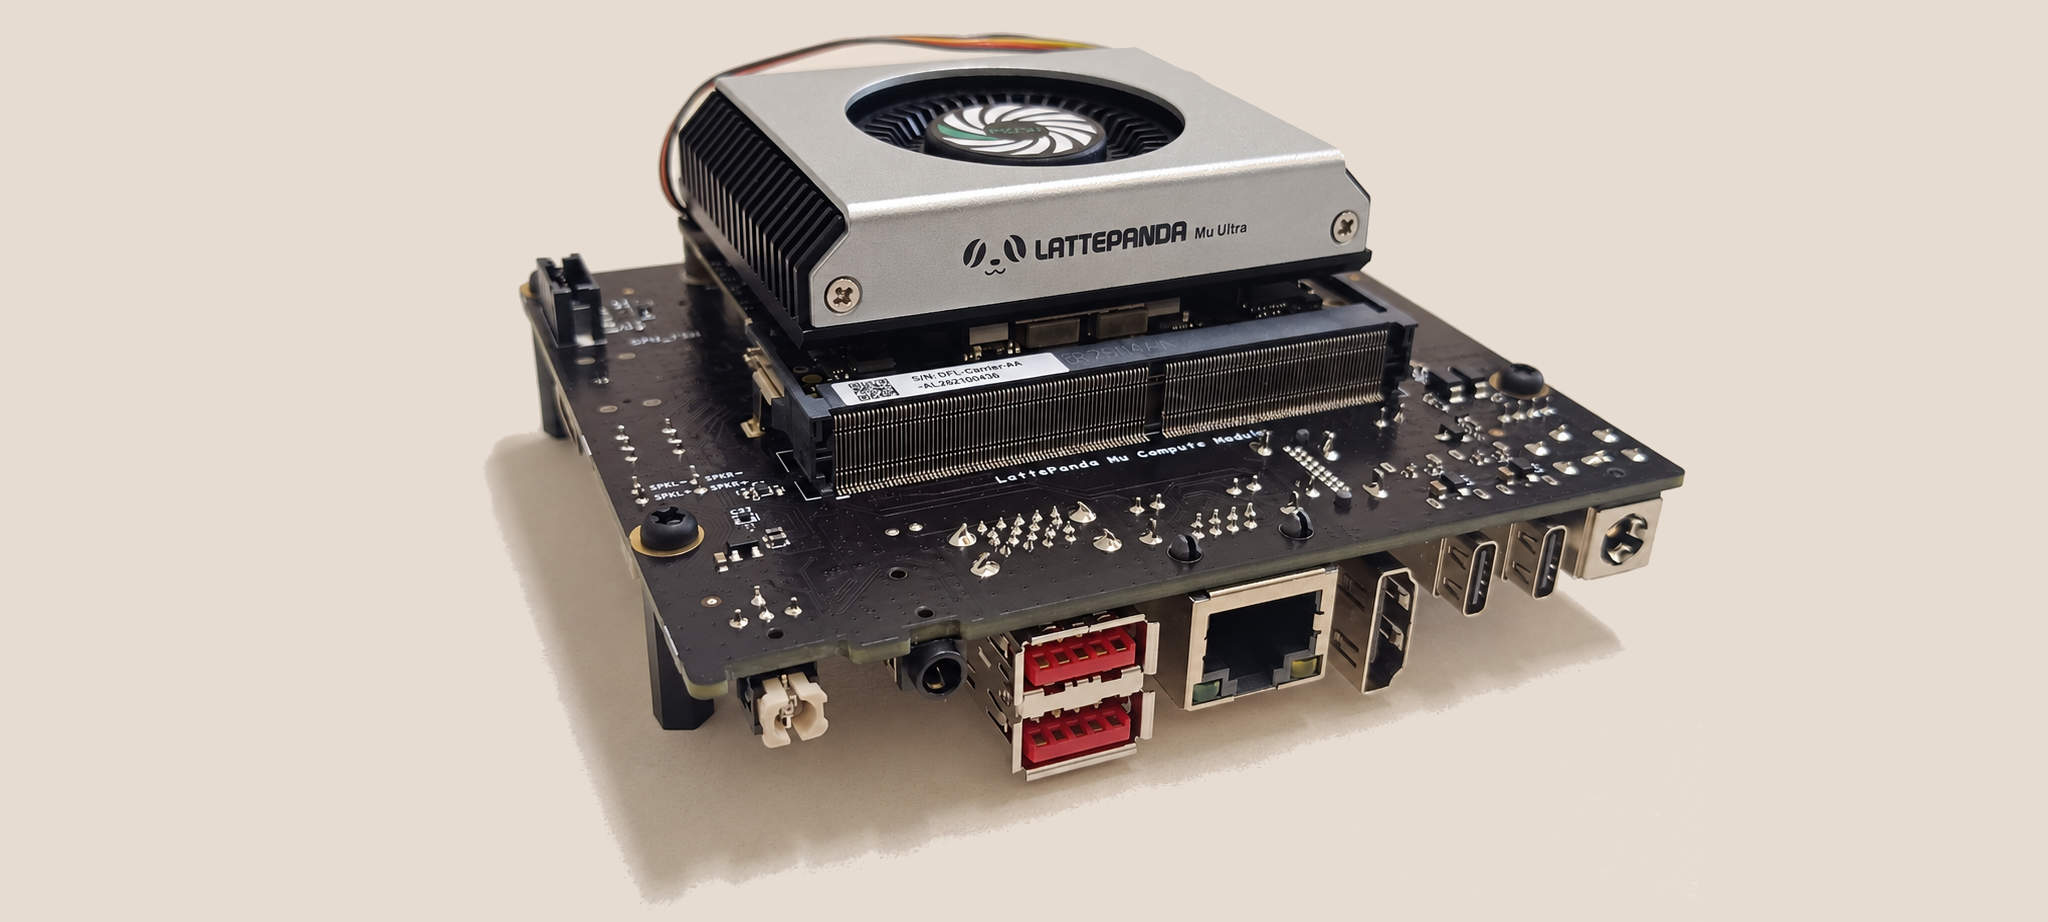
El fabricante ofrece instrucciones detalladas de instalación y configuración en la página de documentación oficial del producto. Seguí esas indicaciones y el montaje transcurrió sin problemas reseñables. Empecé fijando el disipador al módulo LattePanda Mu Ultra y después monté el módulo en la placa portadora. A continuación instalé una SSD NVMe M.2 para el sistema operativo y el almacenamiento. Como el paquete no incluía ninguna SSD, reutilicé una WD Blue SN5000 de 500 GB M.2 NVMe procedente de uno de mis análisis anteriores.
Instalación del sistema operativo (Ubuntu 26.04)
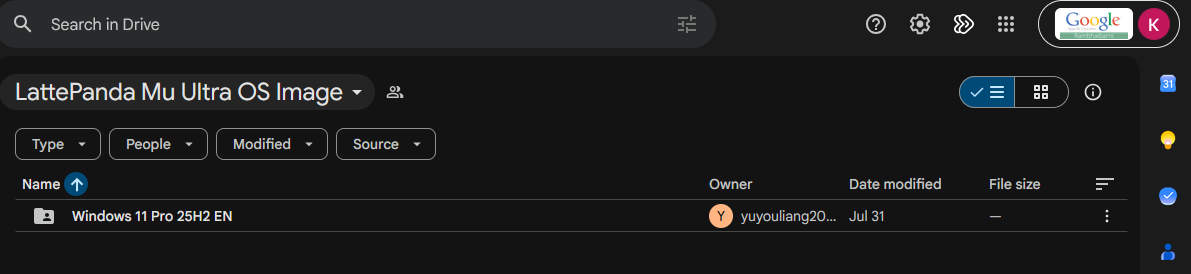
El fabricante proporciona una imagen de recuperación de Windows 11 con los controladores preinstalados. Como alternativa, se puede hacer una instalación limpia de Windows y descargar después los controladores necesarios por separado.
Sin embargo, para este análisis opté por Linux. La guía de instalación del fabricante recomienda Ubuntu 24.04 LTS o posterior, así que elegí Ubuntu 26.04 LTS y utilicé Rufus para crear el medio de instalación. A partir de ahí seguí el procedimiento habitual de Ubuntu, que terminó sin incidencias.
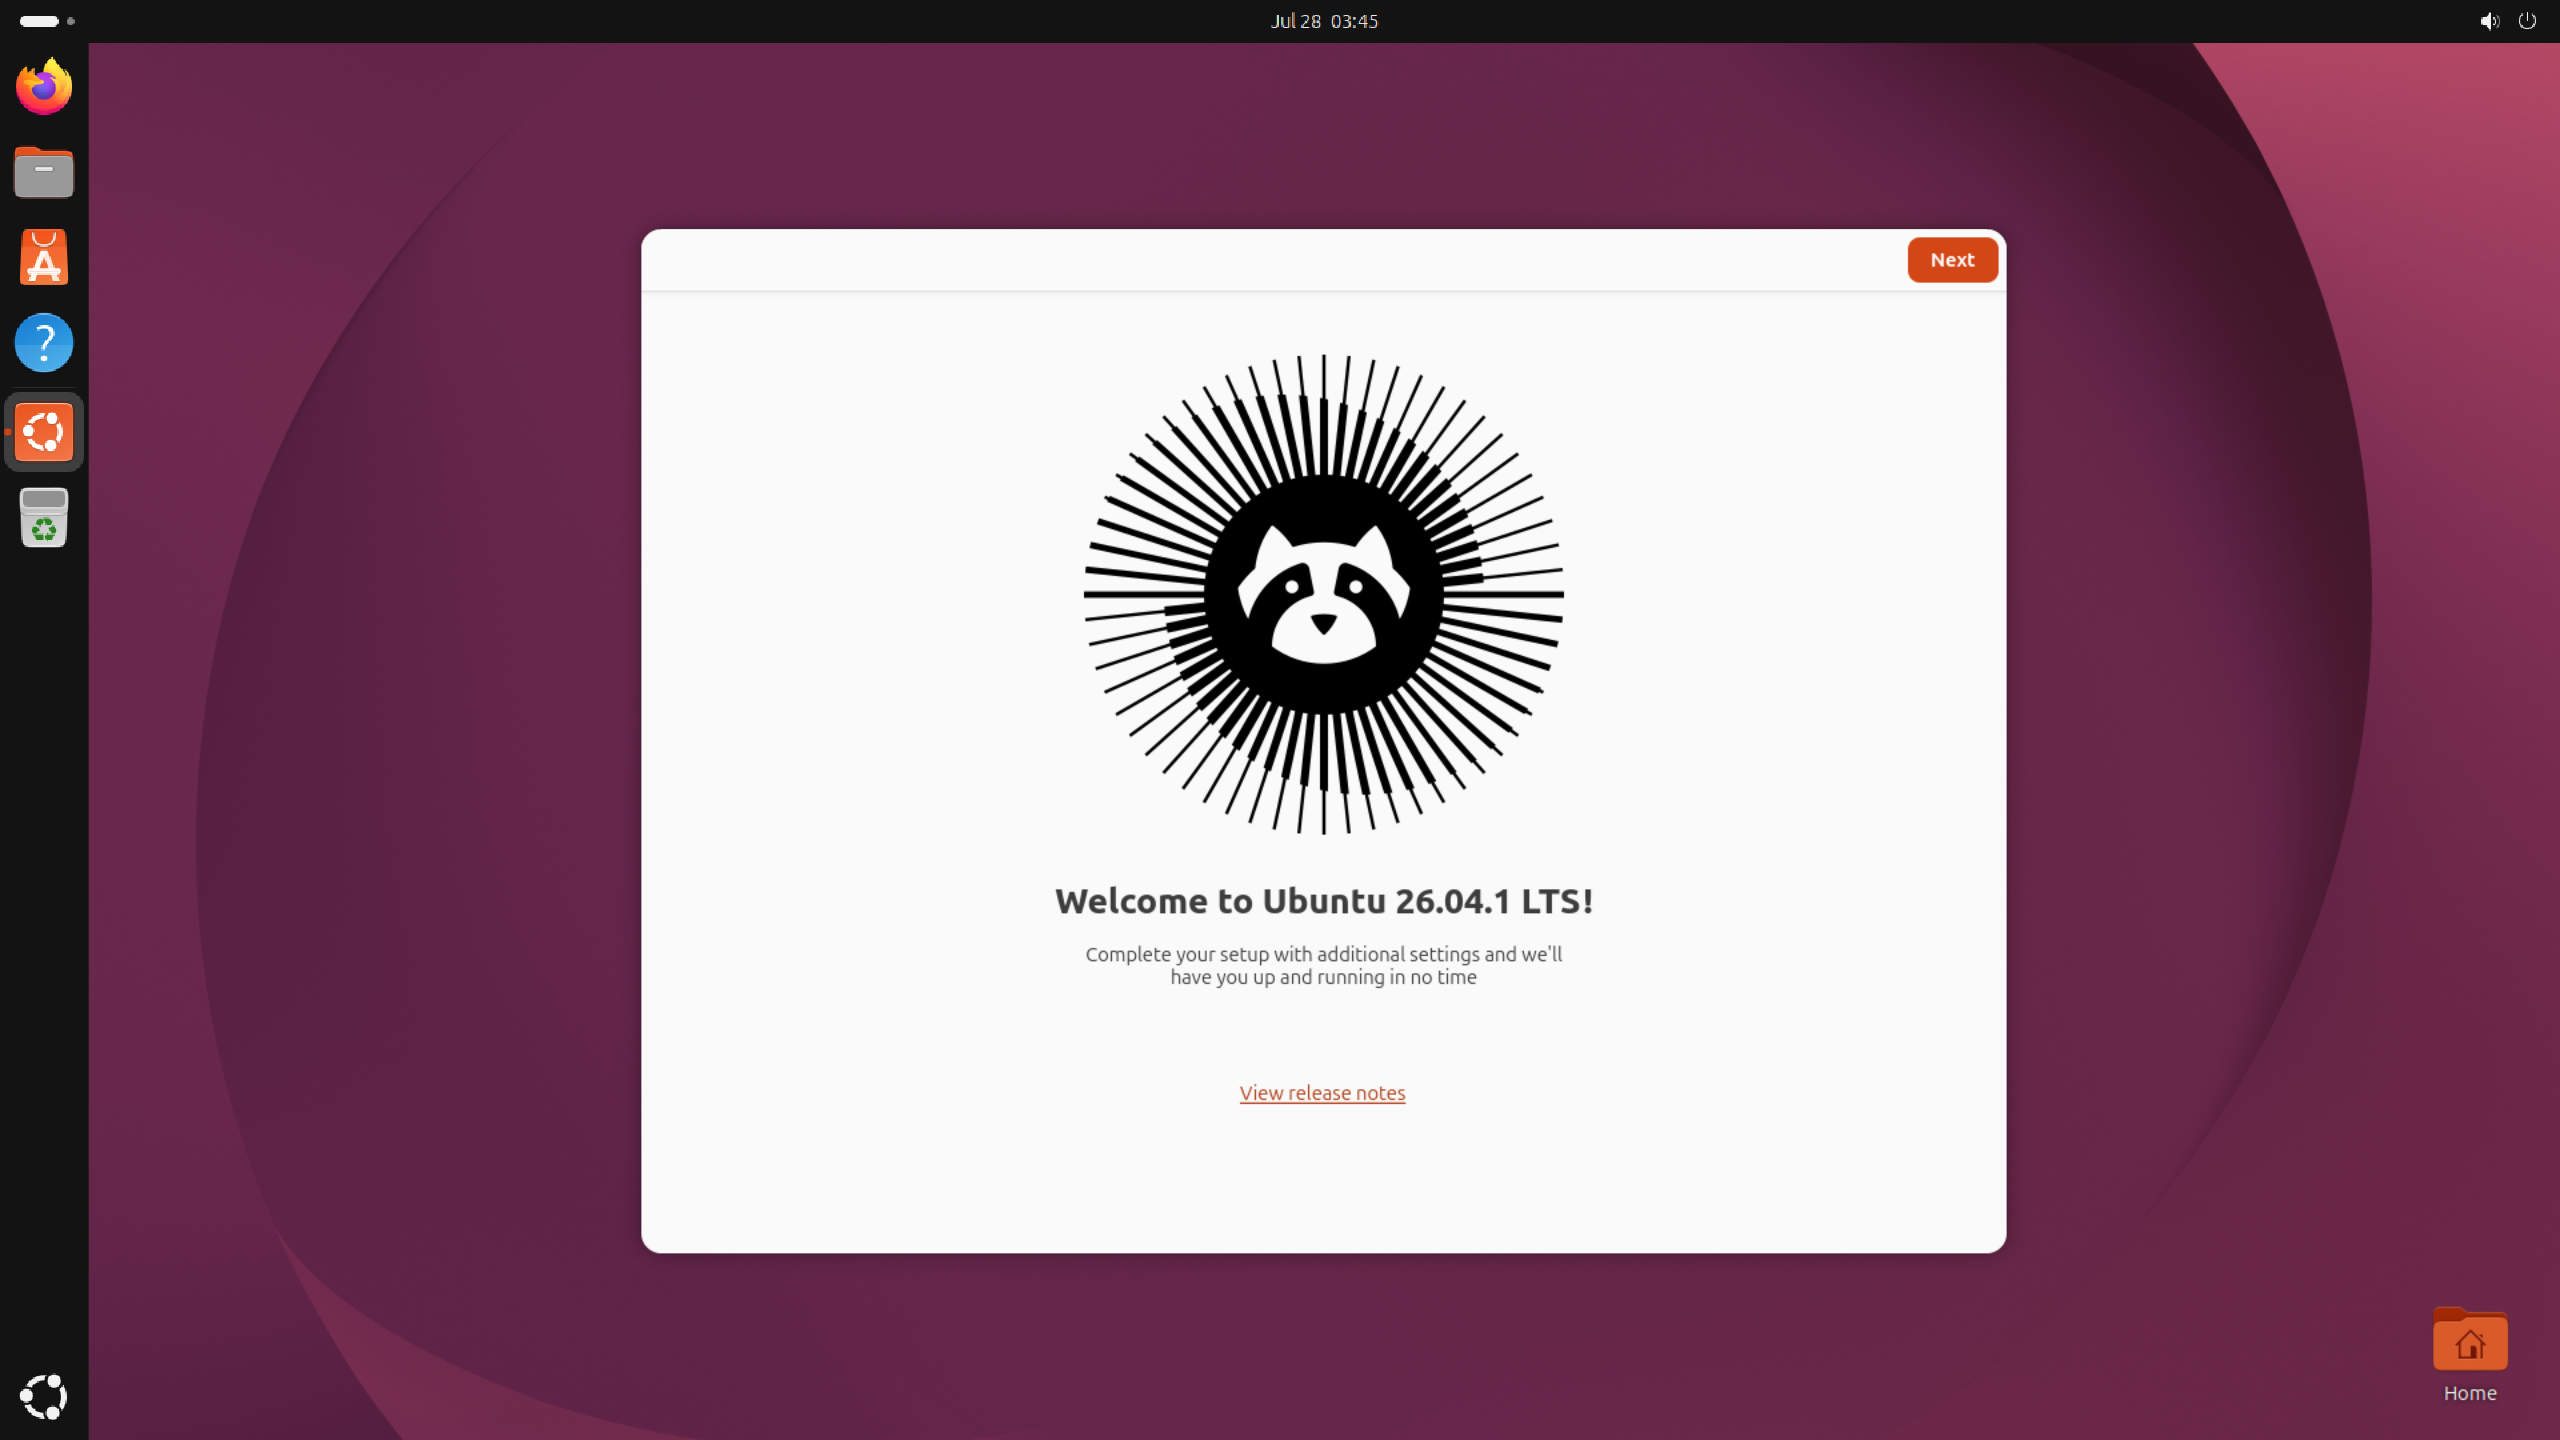
A continuación comprobé la versión del kernel con el comando uname -r, lo que me ayudaría a verificar la compatibilidad del hardware y de los controladores en los pasos siguientes. El comando devolvió 7.0.0-38-generic, la versión de kernel que he utilizado durante todo el análisis.

Instalación de los controladores de Linux
El siguiente paso era instalar los controladores de la GPU y de la NPU. Para la GPU seguí la guía de instalación de controladores gráficos de Intel y elegí el método de instalación de paquetes desde el PPA de Intel.
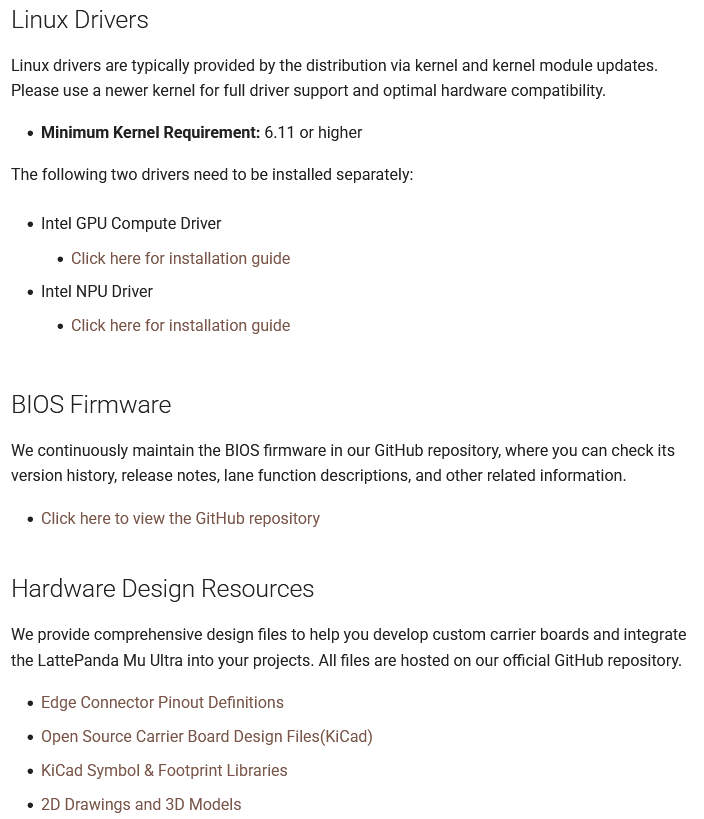
Para la NPU seguí la guía de instalación de los controladores NPU de Intel. Primero configuré el repositorio de paquetes necesario para Ubuntu 26.04 y luego instalé libtbb12, una dependencia de intel-driver-compiler-npu. Después instalé el resto de paquetes del controlador NPU, incluido libze1 para la compatibilidad con Level Zero. Por último, añadí mi cuenta de usuario al grupo render para poder acceder a los dispositivos de GPU y NPU.
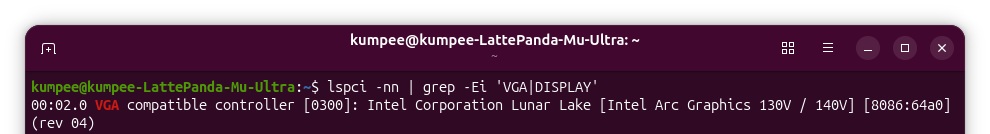
Luego ejecuté varios comandos para comprobar si Linux detectaba y utilizaba correctamente la GPU integrada. Los resultados confirmaron que la GPU Intel Arc Graphics (ID PCI 8086:64a0) se reconocía, con /dev/dri/card0 y /dev/dri/renderD128 disponibles. OpenCL también detectó la GPU, lo que indicaba que los controladores gráficos y de cómputo funcionaban correctamente, como muestran las siguientes imágenes.


Inspección del hardware con inxi
Lo primero que hice fue comprobar el LattePanda Mu Ultra con el comando inxi -Fc0 para revisar su configuración de hardware y su compatibilidad con Linux.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 |
System: Host: kumpee-LattePanda-Mu-Ultra Kernel: 7.0.0-38-generic arch: x86_64 bits: 64 Desktop: GNOME v: 50.1 Distro: Ubuntu 26.04.1 LTS (Resolute Raccoon) Machine: Type: Embedded-pc Mobo: LattePanda model: LattePanda Mu Ultra v: Standard serial: DF-X256V-#A-AL262300171 Firmware: UEFI vendor: LattePanda v: SBCLNLCXR120-A date: 04/30/2026 CPU: Info: 8-core model: Intel Core Ultra 7 256V bits: 64 type: MCP cache: L2: 14 MiB Speed (MHz): avg: 400 min/max: 400/4700:4800:3700 cores: 1: 400 2: 400 3: 400 4: 400 5: 400 6: 400 7: 400 8: 400 Graphics: Device-1: Intel Lunar Lake [Intel Arc Graphics 130V / 140V] driver: xe v: kernel Display: unspecified server: X.Org v: 24.1.10 with: Xwayland v: 24.1.10 driver: dri: iris gpu: xe resolution: 1920x1080~60Hz API: EGL v: 1.5 drivers: iris,swrast platforms: gbm,x11,surfaceless,device API: OpenGL v: 4.6 compat-v: 4.5 vendor: intel mesa v: 26.0.8-1ubuntu0.3 renderer: Mesa Intel Graphics (LNL) Info: Tools: api: clinfo, eglinfo, glxinfo x11: xdriinfo, xdpyinfo, xprop, xrandr Audio: Device-1: Intel Lunar Lake-M HD Audio driver: snd_hda_intel API: ALSA v: k7.0.0-38-generic status: kernel-api Network: Device-1: Intel Ethernet I226-V driver: igc IF: enp2s0 state: up speed: 1000 Mbps duplex: full mac: 00:e0:4c:a2:c5:e3 Drives: Local Storage: total: 465.76 GiB used: 12.82 GiB (2.8%) ID-1: /dev/nvme0n1 vendor: Western Digital model: WD Blue SN5000 500GB size: 465.76 GiB Partition: ID-1: / size: 456.35 GiB used: 12.82 GiB (2.8%) fs: ext4 dev: /dev/nvme0n1p2 ID-2: /boot/efi size: 1.05 GiB used: 6.3 MiB (0.6%) fs: vfat dev: /dev/nvme0n1p1 Swap: ID-1: swap-1 type: file size: 4 GiB used: 0 KiB (0.0%) file: /swap.img Sensors: System Temperatures: cpu: 27.8 C mobo: N/A Fan Speeds (rpm): N/A Info: Memory: total: 16 GiB note: est. available: 14.8 GiB used: 4.56 GiB (30.8%) Processes: 383 Uptime: 10m Shell: Sudo inxi: 3.3.40 |
La placa ejecutaba Ubuntu 26.04.1 LTS (Resolute Raccoon) con el kernel Linux 7.0.0-38 y GNOME 50.1. El sistema reconocía correctamente el procesador Intel Core Ultra 7 256V, con 8 núcleos de CPU y una frecuencia máxima de hasta 4,8 GHz, además de 16 GB de RAM. La placa base y el firmware UEFI también se identificaban correctamente como hardware LattePanda Mu Ultra.
En el apartado gráfico se detectó la GPU Intel Arc integrada (arquitectura Lunar Lake), que funcionaba con el controlador de kernel xe de Linux y Mesa 26.0.8. El sistema informaba de compatibilidad con OpenGL 4.6 y de una resolución de pantalla de 1920 × 1080 a 60 Hz. Entre el resto de hardware detectado figuraban el controlador Ethernet Intel I226-V de 2,5 Gbps, conectado a 1 Gbps a mi switch, y el controlador de audio Intel HD Audio. Para el almacenamiento instalé una SSD NVMe WD Blue SN5000 de 500 GB, que ofrece unos 465,76 GiB de capacidad útil.
En conjunto, los primeros resultados de inxi indican que Ubuntu 26.04.1 LTS reconoce sin problemas los principales componentes del LattePanda Mu Ultra: la CPU, la GPU integrada, la Ethernet, el audio y el almacenamiento NVMe. La temperatura de la CPU en reposo rondaba los 27,8 °C durante esta inspección inicial, aunque se trata solo de una lectura en reposo y no del resultado de una prueba de esfuerzo.
Pruebas de rendimiento del LattePanda Mu Ultra
sbc-bench
A continuación medí el rendimiento del LattePanda Mu Ultra con la herramienta sbc-bench de Thomas Kaiser, que evalúa el rendimiento de la CPU, el ancho de banda de memoria y el comportamiento térmico bajo cargas sostenidas. La prueba identificó correctamente la arquitectura híbrida del Intel Core Ultra 7 256V, formada por cuatro núcleos de rendimiento Lion Cove (P) y cuatro núcleos de eficiencia Skymont (E). En las condiciones iniciales, los núcleos P alcanzaron unos 4,69 GHz y los E llegaron a 3,69 GHz, cerca de sus frecuencias máximas anunciadas.
Información del sistema:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 |
sbc-bench v0.9.72 LattePanda LattePanda Mu Ultra Standard / Ultra 7 256V (Tue, 20 Oct 2026 09:03:22 +0700) Distributor ID: Ubuntu Description: Ubuntu 26.04.1 LTS Release: 26.04 Codename: resolute Device Info: Manufacturer: LattePanda Product Name: LattePanda Mu Ultra Version: Standard SKU Number: LattePanda Mu Ultra Family: LattePanda Compute Module BIOS/UEFI: Vendor: LattePanda Version: SBCLNLCXR120-A Release Date: 04/30/2026 BIOS Revision: 5.32 /usr/bin/gcc (Ubuntu 15.2.0-16ubuntu1) 15.2.0 Uptime: 09:03:22 up 2 min, 1 user, load average: 0.33, 0.27, 0.10, 57.0°C, 29135556 Linux 7.0.0-38-generic (kumpee-LattePanda-Mu-Ultra) 10/20/26 _x86_64_ (8 CPU) avg-cpu: %user %nice %system %iowait %steal %idle 2.88 0.10 2.25 0.33 0.00 94.44 Device tps kB_read/s kB_wrtn/s kB_dscd/s kB_read kB_wrtn kB_dscd nvme0n1 268.28 8857.44 740.27 0.00 1160679 97005 0 total used free shared buff/cache available Mem: 14Gi 1.5Gi 13Gi 88Mi 469Mi 13Gi Swap: 4.0Gi 0B 4.0Gi Filename Type Size Used Priority /swap.img file 4194300 0 -1 ########################################################################## Intel P-States: Intel P-state driver initializing, HWP enabled Intel Hardware Feedback Interface enabled (2 core types) Powercap present. You might want to check with "powercap-info -p intel-rapl" Checking cpufreq OPP for cpu0-cpu3 (Lion Cove): Cpufreq OPP: 4700 Measured: 4685 (4685.871/4685.542/4685.542) Cpufreq OPP: 400 Measured: 395 (395.819/395.795/395.702) (-1.2%) Checking cpufreq OPP for cpu4-cpu7 (Skymont): Cpufreq OPP: 3700 Measured: 3687 (3687.656/3687.613/3687.571) Cpufreq OPP: 400 Measured: 398 (399.868/398.560/396.703) ########################################################################## Hardware sensors: coretemp-isa-0000 Package id 0: +50.0 C (high = +100.0 C, crit = +100.0 C) Core 0: +48.0 C (high = +100.0 C, crit = +100.0 C) Core 4: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 8: +46.0 C (high = +100.0 C, crit = +100.0 C) Core 12: +46.0 C (high = +100.0 C, crit = +100.0 C) Core 32: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 33: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 34: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 35: +45.0 C (high = +100.0 C, crit = +100.0 C) acpitz_0-acpi-0 temp1: +27.8 C nvme-pci-0100 Composite: +37.9 C (low = -40.1 C, high = +83.8 C) (crit = +87.8 C) Sensor 1: +57.9 C (low = -273.1 C, high = +65261.8 C) Sensor 2: +31.9 C (low = -273.1 C, high = +65261.8 C) /dev/nvme0: 38°C ... |
Las pruebas de memoria mostraron un buen rendimiento: el núcleo P alcanzó unos 24,3 GB/s en la prueba memcpy, frente a 15,3 GB/s de un núcleo E. Para medir la CPU, sbc-bench utiliza el benchmark de compresión y descompresión de 7-Zip, que evalúa tanto el procesamiento de un solo hilo como el multihilo. En la prueba monohilo, el núcleo P obtuvo una puntuación global de 4.670 MIPS, mientras que el núcleo E se quedó en 4.257 MIPS. Con los ocho núcleos funcionando a la vez, la prueba multihilo arrojó 22.464, 19.894 y 19.936 MIPS en tres ejecuciones consecutivas, con una media de unos 20.760 MIPS.
|
1 2 3 4 5 6 7 8 9 |
* cpu0 (Lion Cove): memcpy: 24269.5 MB/s, memchr: 29996.9 MB/s, memset: 95368.2 MB/s * cpu4 (Skymont): memcpy: 15307.0 MB/s, memchr: 24473.3 MB/s, memset: 23589.8 MB/s * cpu0 (Lion Cove) 16M latency: 31.68 26.24 32.37 26.49 31.51 28.43 29.62 40.94 * cpu4 (Skymont) 16M latency: 133.9 78.47 97.07 87.15 96.37 66.20 52.67 52.36 * cpu0 (Lion Cove) 128M latency: 131.1 124.0 130.3 122.9 130.8 119.5 102.0 91.82 * cpu4 (Skymont) 128M latency: 127.4 136.7 139.8 137.5 134.9 122.1 115.5 109.7 * 7-zip MIPS (3 consecutive runs): 22464, 19894, 19936 (20760 avg), single-threaded: 4670 * `aes-256-cbc 1068105.16k 1321878.95k 1420131.84k 1466167.30k 1483849.73k 1261436.93k (Lion Cove)` * `aes-256-cbc 1127751.79k 1282259.52k 1325331.03k 1336898.56k 1340235.78k 1338862.25k (Skymont)` |
El comportamiento térmico fue uno de los hallazgos más interesantes. Durante las pruebas intensivas, la temperatura del paquete de la CPU llegó con frecuencia a 95-96 °C y el sistema mostró claros signos de limitación térmica. Con carga plena sostenida, la frecuencia de los núcleos P bajó de unos 4,7 GHz a alrededor de 2,1-2,2 GHz, una reducción importante respecto a la frecuencia turbo inicial.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 |
... ########################################################################## Testing maximum cpufreq again, still under full load. System health now: Time big.LITTLE load %cpu %sys %usr %nice %io %irq Temp 09:16:41: 2100/1880MHz 8.03 100% 0% 99% 0% 0% 0% 96.0°C Checking cpufreq OPP for cpu0-cpu3 (Lion Cove): Cpufreq OPP: 2200 Measured: 2191 (2191.205/2191.156/2191.132) Checking cpufreq OPP for cpu4-cpu7 (Skymont): Cpufreq OPP: 3700 Measured: 3687 (3688.081/3687.826/3687.741) ########################################################################## ... System health while running 7-zip single core benchmark: Time big.LITTLE load %cpu %sys %usr %nice %io %irq Temp 09:08:12: 3728/3701MHz 1.04 11% 0% 10% 0% 0% 0% 95.0°C 09:08:17: 3637/3664MHz 1.03 12% 0% 12% 0% 0% 0% 96.0°C 09:08:22: 3659/3687MHz 1.03 12% 0% 12% 0% 0% 0% 96.0°C 09:08:27: 3669/3413MHz 1.03 12% 0% 12% 0% 0% 0% 96.0°C 09:08:32: 3596/3702MHz 1.02 12% 0% 12% 0% 0% 0% 96.0°C 09:08:37: 3652/3700MHz 1.02 12% 0% 12% 0% 0% 0% 95.0°C 09:08:42: 3528/3702MHz 1.02 12% 0% 12% 0% 0% 0% 96.0°C 09:08:47: 4515/3701MHz 1.02 12% 0% 12% 0% 0% 0% 87.0°C 09:08:52: 400/3701MHz 1.02 12% 0% 12% 0% 0% 0% 85.0°C 09:08:57: 400/3701MHz 1.02 12% 0% 12% 0% 0% 0% 81.0°C 09:09:02: 709/3701MHz 1.01 12% 0% 12% 0% 0% 0% 82.0°C 09:09:07: 820/3701MHz 1.01 12% 0% 12% 0% 0% 0% 80.0°C 09:09:12: 402/3701MHz 1.01 12% 0% 12% 0% 0% 0% 79.0°C System health while running 7-zip multi core benchmark: Time big.LITTLE load %cpu %sys %usr %nice %io %irq Temp 09:09:17: 3000/3401MHz 1.01 12% 0% 10% 0% 0% 0% 96.0°C 09:09:27: 1710/2400MHz 1.52 85% 0% 85% 0% 0% 0% 96.0°C 09:09:37: 2094/2672MHz 1.96 79% 0% 79% 0% 0% 0% 96.0°C 09:09:47: 455/3701MHz 2.89 90% 0% 89% 0% 0% 0% 96.0°C 09:09:59: 1911/2200MHz 3.60 83% 1% 82% 0% 0% 0% 96.0°C 09:10:11: 869/ 800MHz 4.20 84% 0% 84% 0% 0% 0% 95.0°C 09:10:23: 1986/2200MHz 5.11 92% 0% 92% 0% 0% 0% 96.0°C 09:10:35: 2147/1900MHz 5.04 76% 0% 75% 0% 0% 0% 96.0°C 09:10:47: 1888/2200MHz 5.58 74% 1% 73% 0% 0% 0% 96.0°C 09:10:59: 1865/2200MHz 6.19 82% 0% 82% 0% 0% 0% 96.0°C 09:11:11: 1895/2300MHz 5.91 79% 0% 79% 0% 0% 0% 96.0°C 09:11:23: 2060/2200MHz 6.13 77% 0% 77% 0% 0% 0% 96.0°C 09:11:34: 1352/2200MHz 5.86 73% 0% 73% 0% 0% 0% 96.0°C 09:11:44: 1900/1500MHz 6.19 96% 0% 95% 0% 0% 0% 95.0°C ... |
Geekbench 7
También evalué el rendimiento de la CPU y la GPU del LattePanda Mu Ultra con Geekbench 7.1.0. Con la opción --gpu-list, Geekbench detectó correctamente la GPU Intel Arc Graphics integrada tanto a través de OpenCL como de Vulkan.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Downloads/Geekbench-7.1.0$ ./geekbench7 --gpu-list Geekbench 7.1.0 : https://www.geekbench.com/ ... OpenCL +-------------+-----------+---------------------------+ | Platform ID | Device ID | Description | +-------------+-----------+---------------------------+ | 0 | 0 | Intel(R) Arc(TM) Graphics | +-------------+-----------+---------------------------+ Vulkan +-------------+-----------+----------------------------------+ | Platform ID | Device ID | Description | +-------------+-----------+----------------------------------+ | 0 | 0 | Intel(R) Graphics (LNL) | +-------------+-----------+----------------------------------+ | 0 | 1 | llvmpipe (LLVM 21.1.8, 256 bits) | +-------------+-----------+----------------------------------+ |
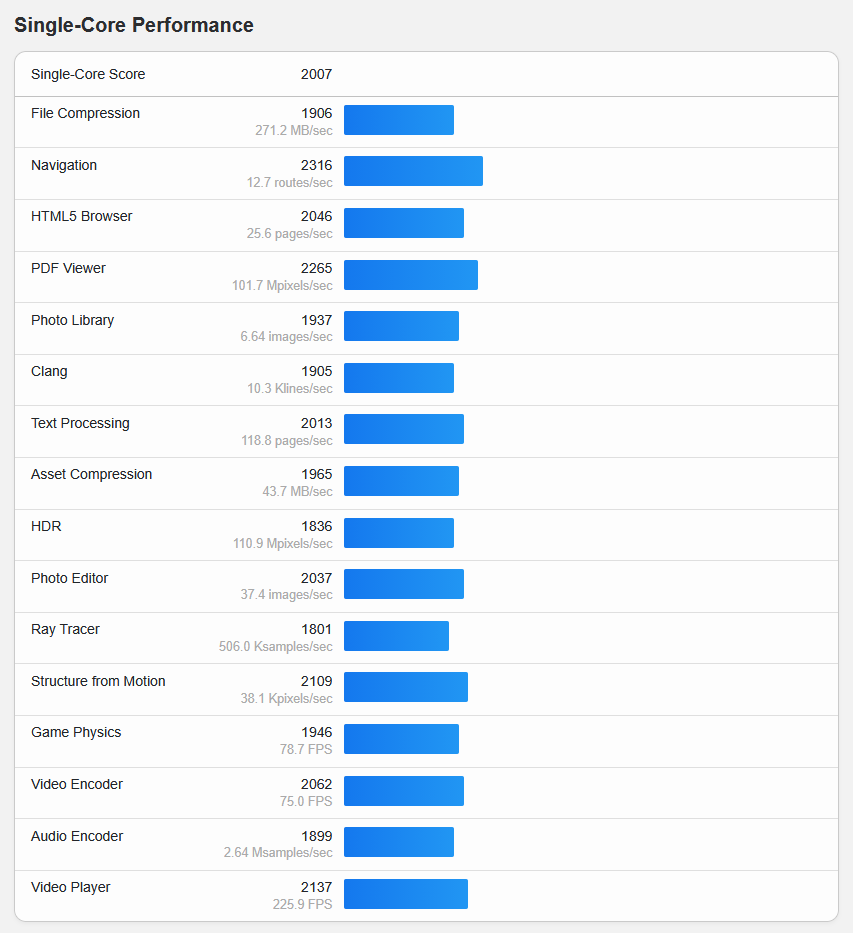
En rendimiento de CPU, el LattePanda Mu Ultra obtuvo 2.007 puntos en mononúcleo y 6.813 en multinúcleo. En las pruebas mononúcleo, el procesador logró 2.316 puntos en Navigation, 2.109 en SfM y 2.062 en codificación de vídeo.
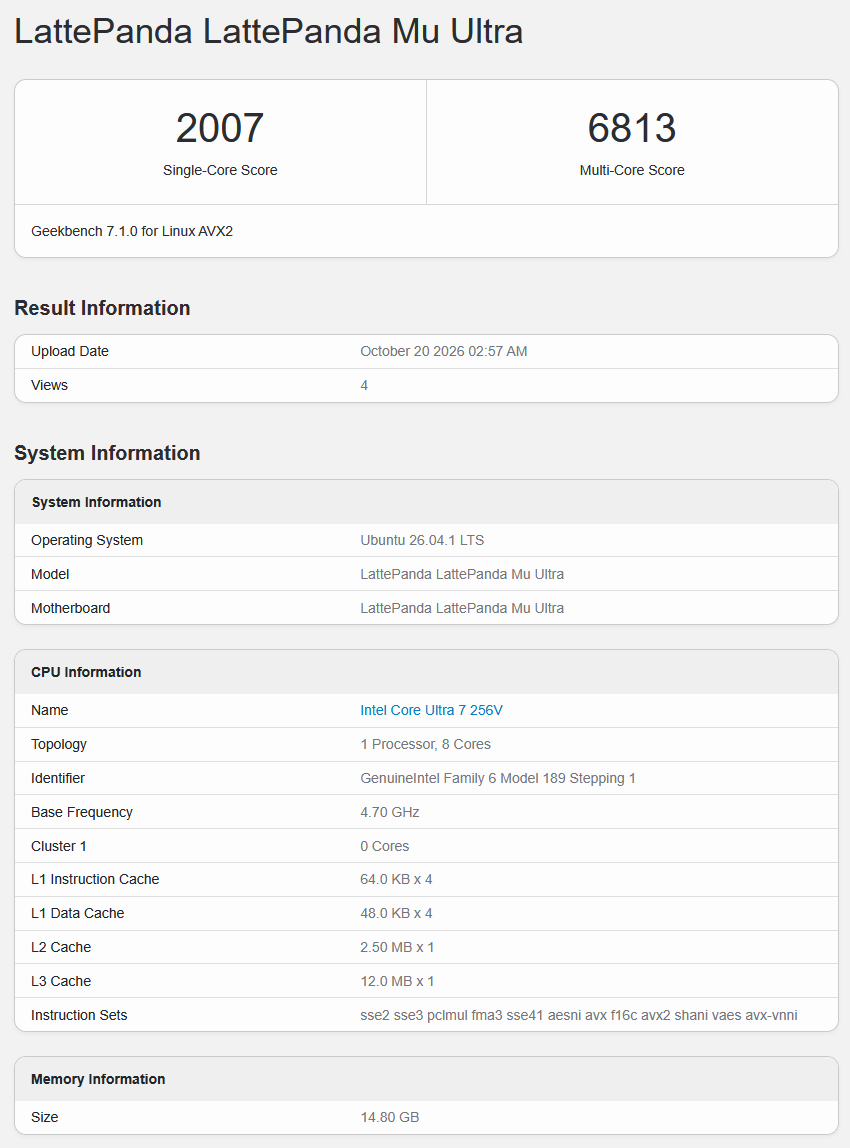
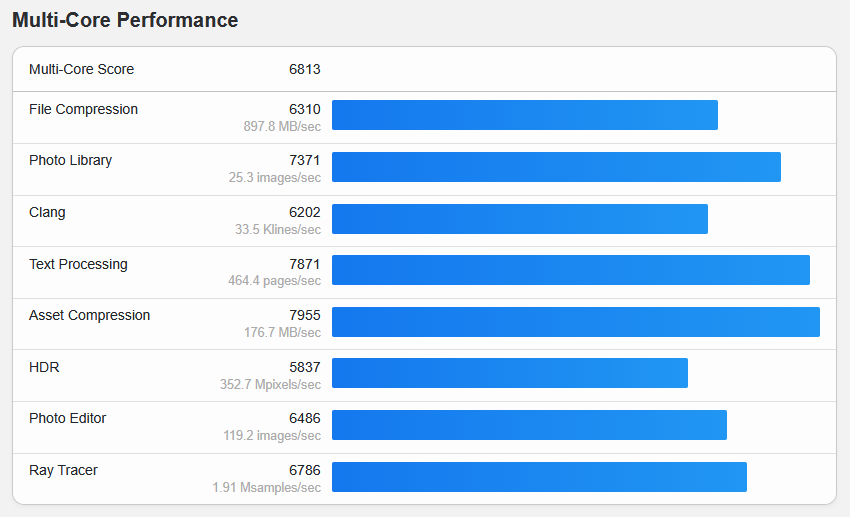
En multinúcleo, las mejores puntuaciones se registraron en compresión de activos (7.955 puntos), procesamiento de texto (7.871 puntos) y biblioteca de fotos (7.371 puntos). Estos resultados demuestran la capacidad del procesador tanto en computación de propósito general como en cargas de trabajo paralelas.
En rendimiento de GPU, la Intel Arc Graphics integrada logró una puntuación OpenCL de 24.963. Entre las pruebas, Super Resolution alcanzó la mejor cifra, con 50.454 puntos, seguida de Background Blur con 31.707, Face Tracking con 28.470 y Feature Matching con 28.203. Estos resultados ponen de relieve el potencial de la GPU integrada para el procesamiento de imágenes, la visión por computador y las aplicaciones aceleradas por GPU.
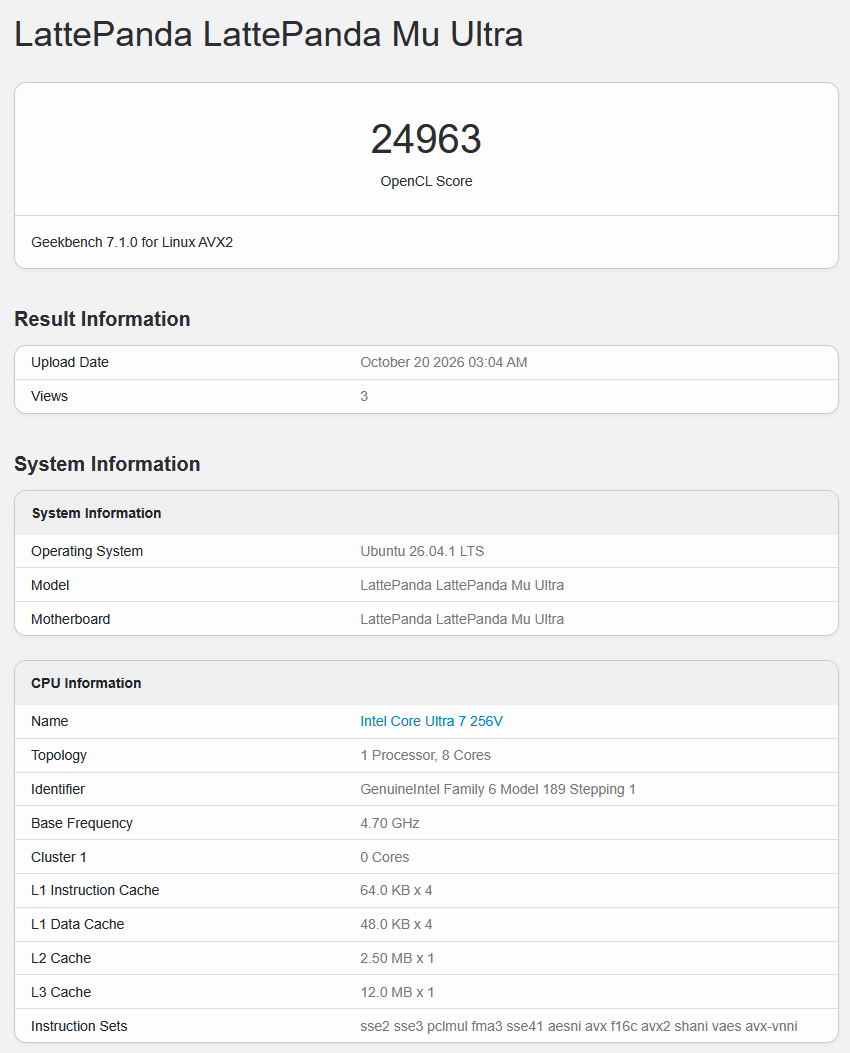
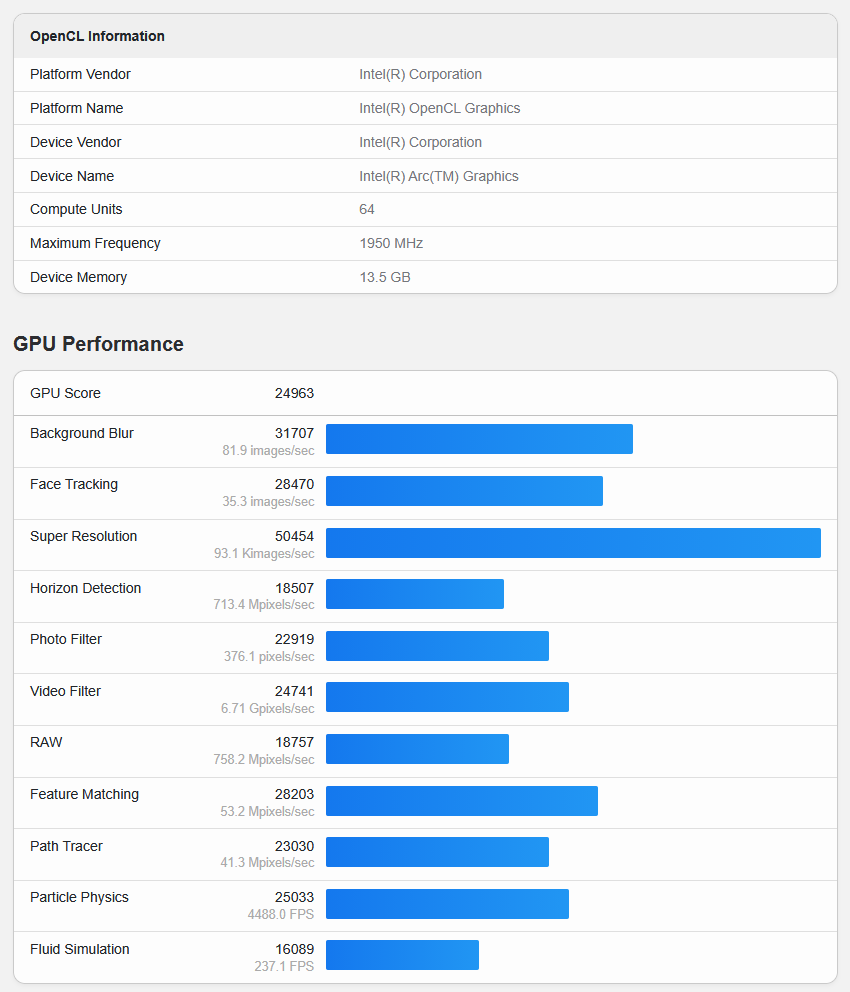
En conjunto, los resultados de Geekbench 7 muestran que el LattePanda Mu Ultra ofrece un rendimiento sólido de CPU y GPU integrada para su tamaño compacto, lo que lo hace adecuado para aplicaciones multimedia, de visión por computador y de IA en el borde.
Evaluación del rendimiento de IA con Geekbench AI
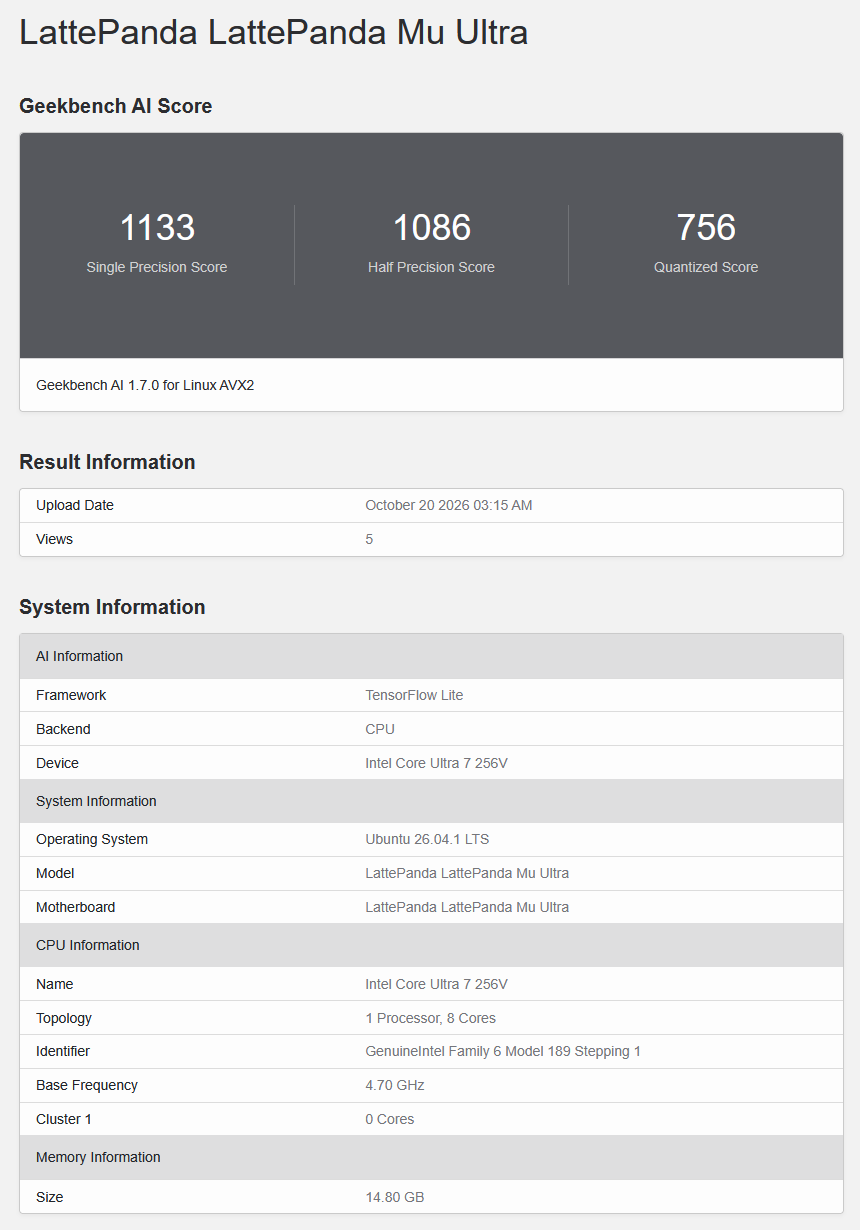
Para evaluar la capacidad de cómputo de IA del LattePanda Mu Ultra empecé por Geekbench AI 1.7.0. La herramienta detectó varios frameworks de inferencia, como TensorFlow Lite, ONNX e Intel OpenVINO para las pruebas de CPU, además de OpenVINO para la GPU Intel Arc integrada.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Downloads/GeekbenchAI-1.7.0$ ./banff --ai-list Geekbench AI 1.7.0 : https://www.geekbench.com/ai/ Geekbench AI requires an active internet connection and automatically uploads benchmark results to the Geekbench Browser. +-----------------+----+---------+----+----------------------------------+----+ | Framework | ID | Backend | ID | Device | ID | +-----------------+----+---------+----+----------------------------------+----+ | TensorFlow Lite | 1 | CPU | 1 | Intel Core Ultra 7 256V | 0 | +-----------------+----+---------+----+----------------------------------+----+ | ONNX | 3 | CPU | 1 | Intel Core Ultra 7 256V | 0 | +-----------------+----+---------+----+----------------------------------+----+ | OpenVINO | 4 | CPU | 1 | Intel(R) Core(TM) Ultra 7 256V | 0 | +-----------------+----+---------+----+----------------------------------+----+ | OpenVINO | 4 | GPU | 2 | Intel(R) Arc(TM) Graphics (iGPU) | 1 | |
Con el backend TensorFlow Lite para CPU
Con el backend TensorFlow Lite para CPU, el LattePanda Mu Ultra obtuvo 1.133 puntos en precisión simple (SP), 1.086 en media precisión (HP) y 756 en inferencia cuantizada (Q). En las pruebas individuales, la clasificación de imágenes alcanzó 189,9 IPS (SP), la detección de objetos llegó a 56,4 IPS (SP), la segmentación de imágenes se quedó en 17,1 IPS (SP) y la estimación de profundidad alcanzó 10,3 IPS (SP). Otros resultados fueron 15,6 IPS (HP) en detección de rostros, 1,67 IPS (Q) en estimación de poses y 27,6 IPS (Q) en superresolución de imágenes.
Con el backend Intel OpenVINO para CPU
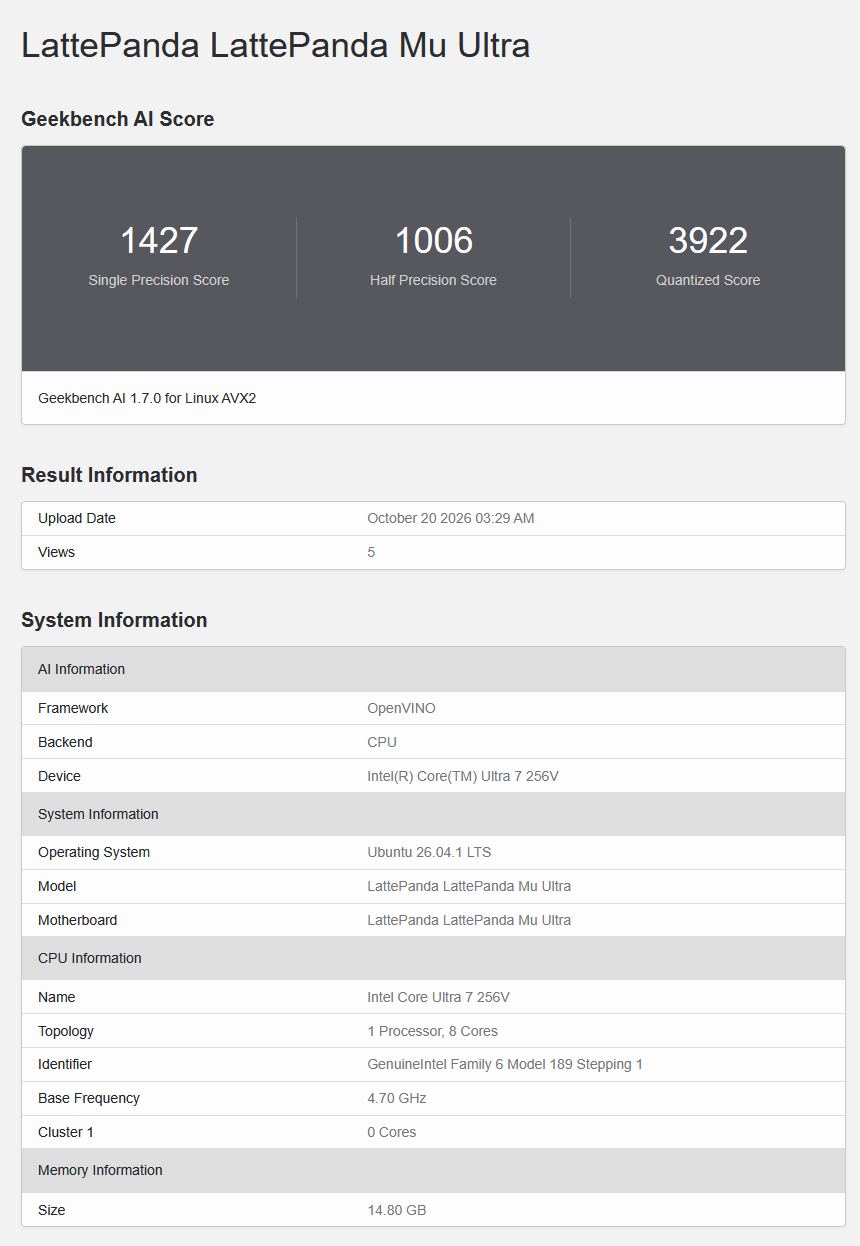
Con el backend Intel OpenVINO para CPU, el módulo obtuvo 1.427 puntos en precisión simple (SP), 1.006 en media precisión (HP) y 3.922 en inferencia cuantizada (Q). En las pruebas individuales, la clasificación de imágenes alcanzó 184,9 IPS (SP), la detección de objetos 58,9 IPS (SP), la segmentación de imágenes 17,6 IPS (SP) y la estimación de profundidad 14,4 IPS (SP). Otros resultados fueron 22,4 IPS (HP) en detección de rostros, 5,98 IPS (Q) en estimación de poses y 122,0 IPS (Q) en superresolución de imágenes.
Con el backend ONNX para CPU
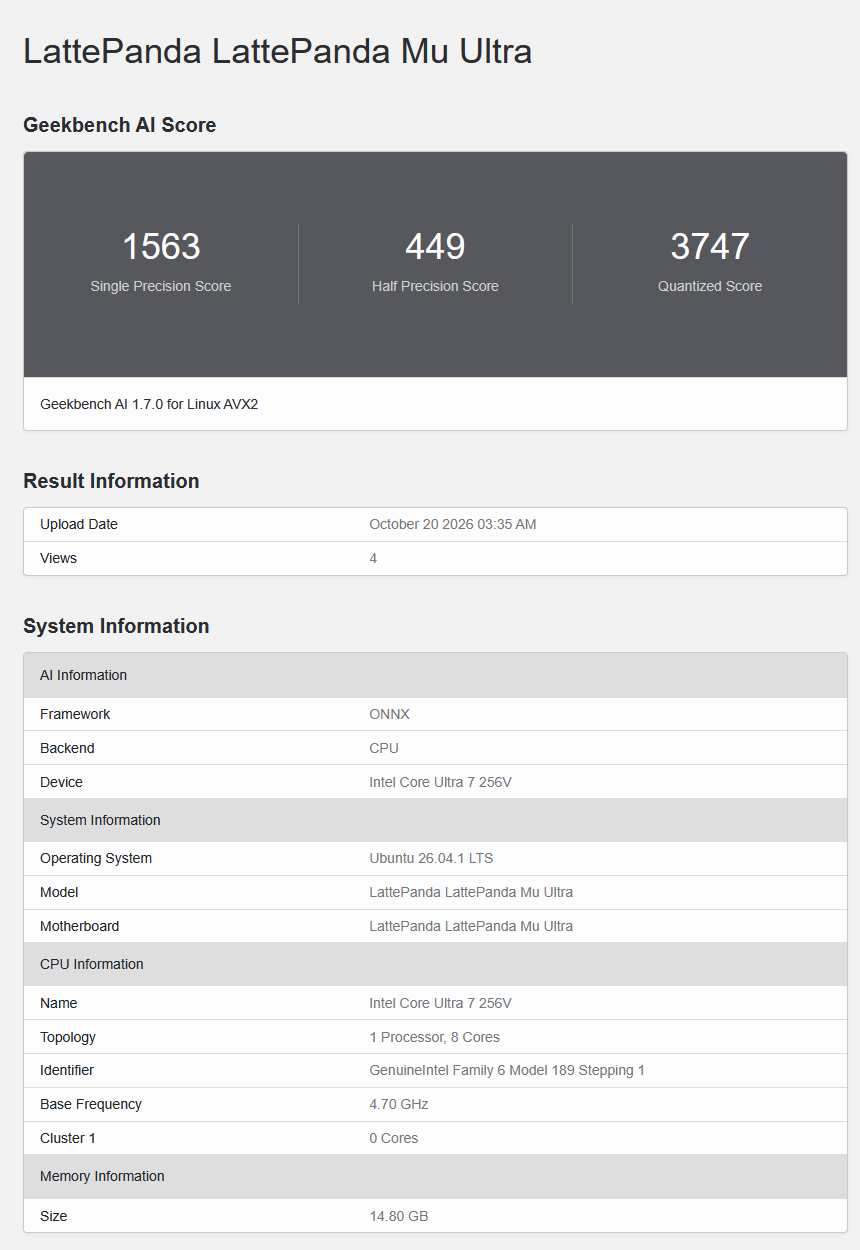
Con el backend ONNX para CPU, el LattePanda Mu Ultra obtuvo 1.563 puntos en precisión simple (SP), 449 en media precisión (HP) y 3.747 en inferencia cuantizada (Q). En las pruebas individuales, la clasificación de imágenes alcanzó 219,0 IPS (SP), la detección de objetos 75,5 IPS (SP), la segmentación de imágenes 13,2 IPS (SP) y la estimación de profundidad 21,1 IPS (SP). Otros resultados fueron 78,7 IPS (Q) en detección de rostros, 10,6 IPS (Q) en estimación de poses y 88,9 IPS (Q) en superresolución de imágenes.
Con el backend OpenVINO para GPU: falló
También probé Geekbench AI 1.7.0 con el backend OpenVINO para GPU. Aunque detectó correctamente la GPU Intel Arc integrada, la prueba falló en la primera ejecución de clasificación de imágenes con un error OpenCL CL_OUT_OF_RESOURCES. Puede deberse a problemas de compatibilidad entre Geekbench AI, OpenVINO y los controladores de GPU instalados, ya que otras aplicaciones aceleradas por GPU funcionaban sin problemas.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
AI Information Framework OpenVINO Backend GPU Device Intel(R) Arc(TM) Graphics (iGPU) System Information Operating System Ubuntu 26.04.1 LTS Model LattePanda LattePanda Mu Ultra Motherboard LattePanda LattePanda Mu Ultra BIOS LattePanda SBCLNLCXR120-A CPU Information Name Intel Core Ultra 7 256V Topology 1 Processor, 8 Cores Identifier GenuineIntel Family 6 Model 189 Stepping 1 Base Frequency 4.70 GHz Memory Information Size 14.8 GB Running Image Classification (SP) Geekbench AI encountered an internal error. Contact support@primatelabs.com for help. Internal error message: Exception from src/inference/src/cpp/infer_request.cpp:224: Exception from src/plugins/intel_gpu/src/runtime/ocl/ocl_stream.cpp:376: [GPU] clFinish, error code: -5 CL_OUT_OF_RESOURCES |
En cualquier caso, decidí pasar por alto la prueba fallida y continuar con otros benchmarks, ya que en los apartados siguientes también iba a probar la CPU, la GPU y la NPU con herramientas como llama.cpp y YOLO26. En resumen, en Geekbench AI ONNX fue el mejor en precisión simple, mientras que TensorFlow Lite sacó una ligera ventaja en media precisión. OpenVINO destacó especialmente con modelos cuantizados, con ONNX muy cerca. En general, OpenVINO y ONNX dieron mejores resultados en la mayoría de las pruebas, lo que demuestra hasta qué punto la elección del backend de inferencia puede afectar al rendimiento de IA, incluso sobre el mismo hardware. Aunque la GPU se detectó, al menos una prueba falló con OpenVINO y la NPU no se detectó en absoluto. Esto coincide en líneas generales con lo que vivimos al usar Geekbench AI en nuestro análisis del mini PC GEEKOM IT13 Max (Intel Core Ultra 9 185G) con Ubuntu 26.04.
Reproducción de vídeo en YouTube
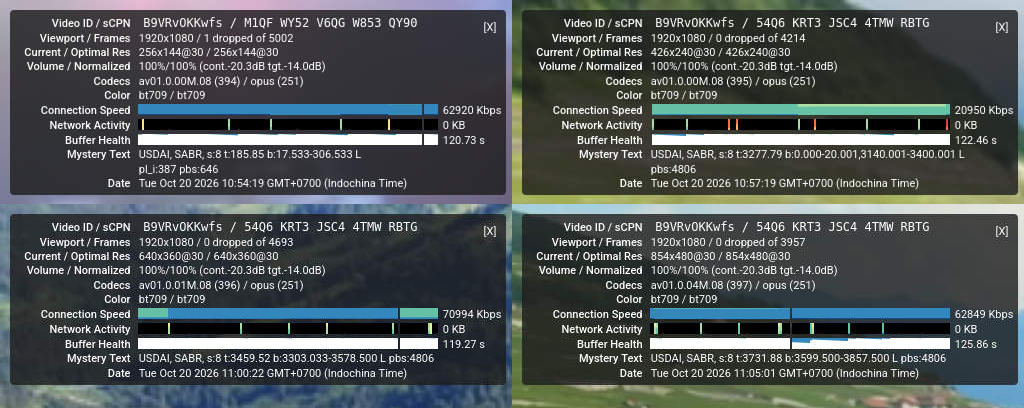
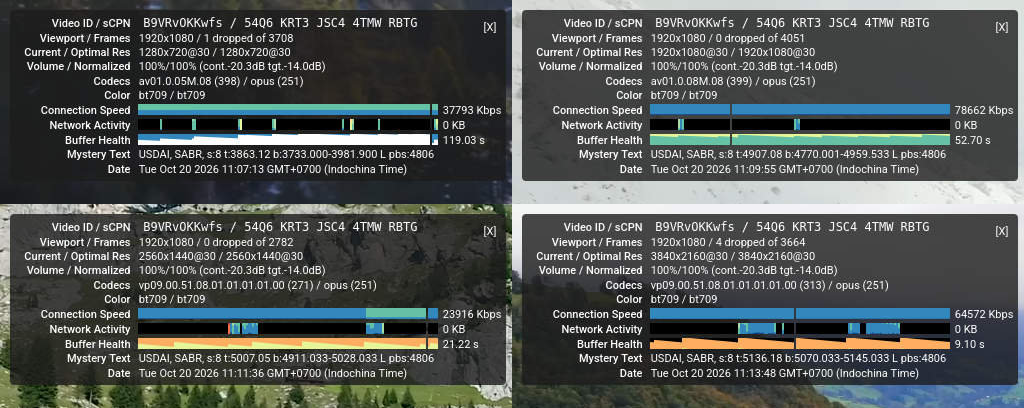
A continuación probé el rendimiento de reproducción de vídeo de YouTube del LattePanda Mu Ultra con vídeos en distintas resoluciones, de 144p a 2160p (4K). Utilicé la función «Stats for nerds» de YouTube para seguir el rendimiento de la reproducción, incluidos los fotogramas descartados. En general, la reproducción fue fluida en todas las resoluciones probadas. La siguiente imagen muestra los resultados de los vídeos reproducidos entre 144p y 480p.
La siguiente imagen muestra el rendimiento de reproducción entre 720p y 2160p (4K). La reproducción siguió siendo fluida en todas las resoluciones probadas.
Las pruebas anteriores se hicieron con el monitor en resolución Full HD (1920 × 1080). Después cambié la resolución de pantalla a 4K (3840 × 2160) y repetí la prueba de reproducción de YouTube, como muestra la siguiente imagen. En conjunto, la reproducción siguió siendo fluida en 4K, con solo unos pocos fotogramas descartados.
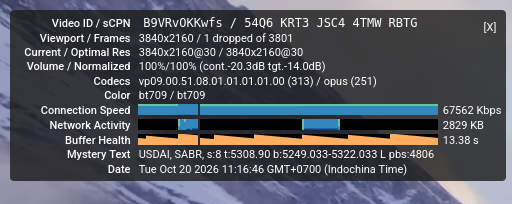
En conjunto, estos resultados demuestran que el LattePanda Mu Ultra reproduce bien vídeos de YouTube en alta resolución, incluidos los vídeos 4K codificados con códecs modernos.
Rendimiento de navegación web con Speedometer 3.1
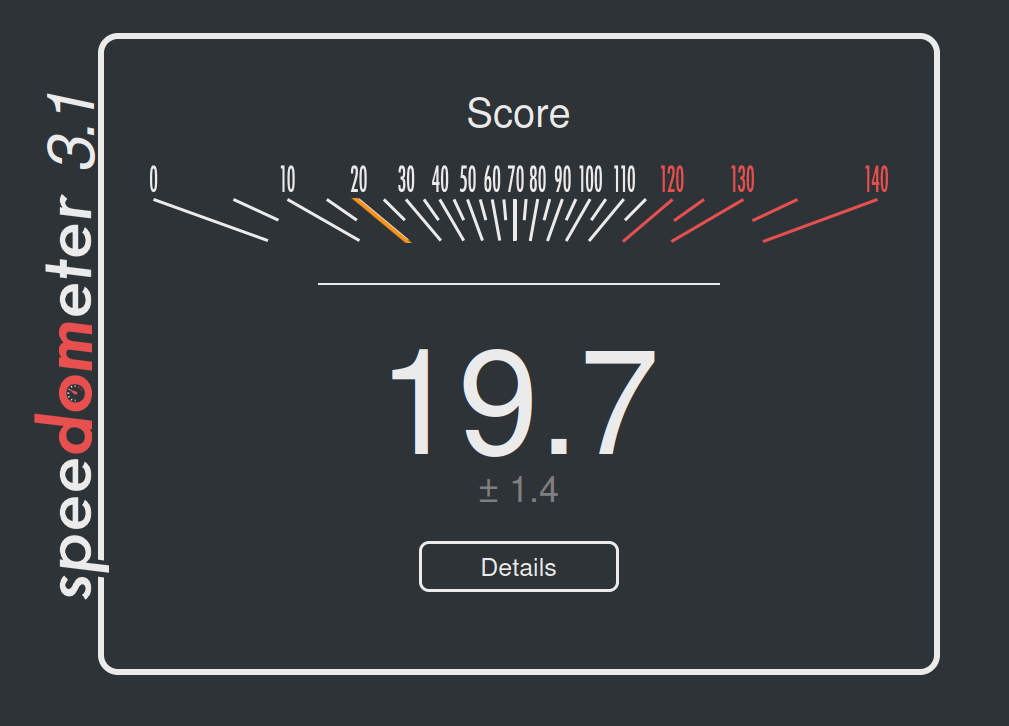
También probé el rendimiento de navegación web del LattePanda Mu Ultra con Speedometer 3.1 en Google Chrome. El LattePanda Mu Ultra obtuvo una puntuación global de 19,7 ± 1,4. En las pruebas individuales, el módulo completó la prueba TodoMVC basada en React en 49,4 ms de media, la de Vue en 31,6 ms y la de Svelte en 22,6 ms. En aplicaciones web más complejas, la prueba del sitio de noticias con Next.js tardó unos 142,8 ms, mientras que la versión con Nuxt terminó en 119,5 ms. Otros resultados fueron 30,7 ms con el editor CodeMirror, 51,8 ms con Chart.js y 72,0 ms en la prueba del panel de rendimiento.
Evaluación de la CPU, la GPU y la NPU con llama.cpp
Comprobé las capacidades Vulkan del sistema con el comando vulkaninfo. Los resultados confirmaron que la GPU integrada de Intel se detectaba, con soporte de Vulkan 1.4 a través del controlador Mesa 26.0.8, lo que indicaba que la GPU estaba lista para seguir probándola con llama.cpp.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 |
... Device Properties and Extensions: ================================= GPU0: VkPhysicalDeviceProperties: --------------------------- apiVersion = 1.4.335 (4211023) driverVersion = 26.0.8 (109051912) vendorID = 0x8086 deviceID = 0x64a0 deviceType = PHYSICAL_DEVICE_TYPE_INTEGRATED_GPU deviceName = Intel(R) Graphics (LNL) ... VkPhysicalDeviceVulkan12Properties: ----------------------------------- driverID = DRIVER_ID_INTEL_OPEN_SOURCE_MESA driverName = Intel open-source Mesa driver driverInfo = Mesa 26.0.8-1ubuntu0.3 ... VkQueueFamilyProperties: ------------------------ queueFlags = QUEUE_GRAPHICS_BIT | QUEUE_COMPUTE_BIT | QUEUE_TRANSFER_BIT |
Después instalé las herramientas y bibliotecas de desarrollo necesarias, como CMake, OpenBLAS y Vulkan, para preparar el sistema para compilar y ejecutar llama.cpp. Tras instalar esos paquetes, cloné el proyecto llama.cpp desde su repositorio oficial de GitHub. Para las pruebas elegí dos modelos cuantizados: Llama 3.2 3B Instruct (Q4_K_M) y Llama 3.1 8B Instruct (Q4_K_M), con un tamaño de archivo de aproximadamente 1,87 GiB y 4,58 GiB respectivamente. Empecé compilando la versión para CPU de llama.cpp, que se completó sin incidencias.
|
1 2 3 4 5 6 7 8 9 |
sudo apt install -y git cmake build-essential ninja-build libvulkan-dev vulkan-tools glslc libshaderc-dev Mesa-vulkan-drivers git clone https://github.com/ggml-org/llama.cpp.git cd llama.cpp cmake -B build-cpu \ -DGGML_VULKAN=OFF \ -DGGML_CUDA=OFF \ -DGGML_BLAS=OFF \ -DGGML_NATIVE=ON \ -DCMAKE_BUILD_TYPE=Release |
A continuación ejecuté las pruebas con ocho hilos de CPU, 512 tokens de entrada, 128 tokens generados y cinco repeticiones por modelo. El modelo de 3B alcanzó 48,08 tokens/s en el procesamiento del prompt y 13,59 tokens/s en la generación de texto.
|
1 2 3 4 5 6 7 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-cpu/bin/llama-bench -m ../models/Llama-3.2-3B-Instruct-Q4_K_M.gguf -ngl 0 -p 512 -t 8 -n 128 -r 5 | model | size | params | backend | threads | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | CPU | 8 | pp512 | 48.08 ± 2.34 | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | CPU | 8 | tg128 | 13.59 ± 0.97 | build: 1d88cb05f (11749) |
Después compilé llama.cpp con soporte de Vulkan para aprovechar la GPU Intel Arc integrada. La compilación terminó correctamente y el backend Vulkan detectó la GPU sin problemas. La GPU alcanzó 854,51 tokens/s en el procesamiento del prompt y 14,14 tokens/s en la generación de texto. En comparación con la CPU, el procesamiento del prompt fue unas 17,8 veces más rápido, mientras que la generación de texto solo mejoró alrededor de un 4 %.
|
1 2 3 4 5 6 7 8 9 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-vulkan/bin/llama-bench -m ../models/Llama-3.2-3B-Instruct-Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 ggml_vulkan: Found 1 Vulkan devices: ggml_vulkan: 0 = Intel(R) Graphics (LNL) (Intel open-source Mesa driver) | uma: 1 | fp16: 1 | bf16: 1 | fp4: 0 | warp size: 32 | shared memory: 49152 | int dot: 1 | matrix cores: KHR_coopmat | model | size | params | backend | ngl | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | --: | --------------: | -------------------: | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | Vulkan | 99 | pp512 | 854.51 ± 6.47 | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | Vulkan | 99 | tg128 | 14.14 ± 0.78 | build: 1d88cb05f (11749) |
Luego repetí la prueba con CPU usando el modelo más grande Llama 3.1 8B Instruct, con los mismos parámetros para que la comparación fuera consistente. La CPU alcanzó 19,40 tokens/s en el procesamiento del prompt y 6,16 tokens/s en la generación de texto. Como era de esperar, el rendimiento bajó con el modelo más grande, sobre todo en la generación secuencial de tokens.
|
1 2 3 4 5 6 7 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-cpu/bin/llama-bench -m ../models/Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf -ngl 0 -t 8 -p 512 -n 128 -r 5 | model | size | params | backend | threads | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | CPU | 8 | pp512 | 19.40 ± 0.42 | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | CPU | 8 | tg128 | 6.16 ± 0.30 | build: 1d88cb05f (11749) |
Por último, probé el modelo de 8B con el backend Vulkan y la descarga en GPU activada. La GPU alcanzó 303,38 tokens/s en el procesamiento del prompt y 6,44 tokens/s en la generación de texto. Esto supone un procesamiento del prompt unas 15,6 veces más rápido que en la CPU, mientras que la generación de texto solo mejoró alrededor de un 4,5 %.
|
1 2 3 4 5 6 7 8 9 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-vulkan/bin/llama-bench -m ../models/Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 ggml_vulkan: Found 1 Vulkan devices: ggml_vulkan: 0 = Intel(R) Graphics (LNL) (Intel open-source Mesa driver) | uma: 1 | fp16: 1 | bf16: 1 | fp4: 0 | warp size: 32 | shared memory: 49152 | int dot: 1 | matrix cores: KHR_coopmat | model | size | params | backend | ngl | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | --: | --------------: | -------------------: | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | Vulkan | 99 | pp512 | 303.38 ± 4.57 | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | Vulkan | 99 | tg128 | 6.44 ± 0.35 | build: 1d88cb05f (11749) |
Los siguientes gráficos comparan el rendimiento de inferencia en CPU y en GPU con los dos modelos Llama.
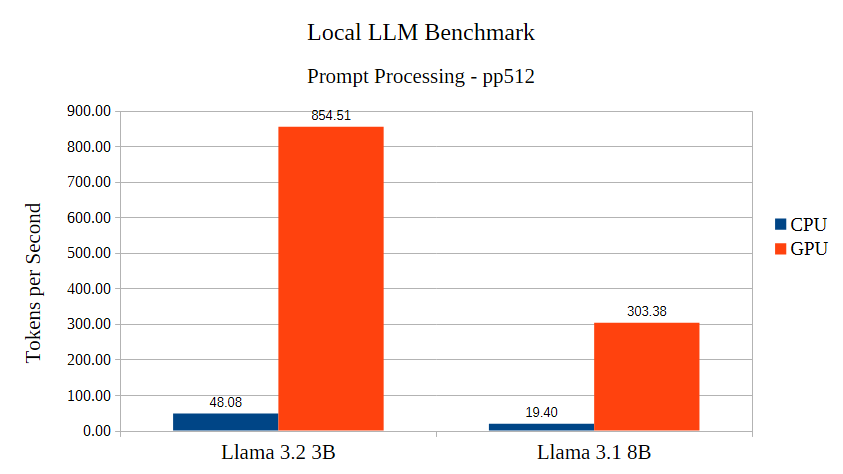
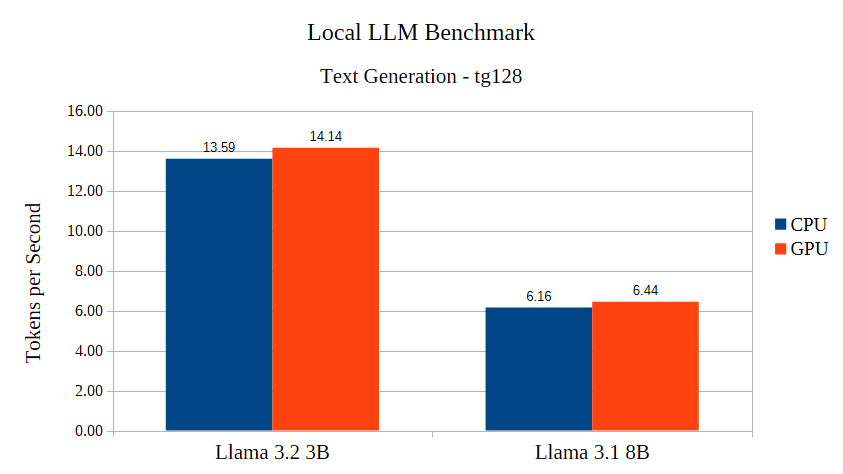
Los resultados demuestran claramente que la aceleración por GPU aporta una ventaja notable en el procesamiento del prompt, sobre todo con secuencias de entrada largas. Sin embargo, el rendimiento de generación de texto es bastante similar entre CPU y GPU en estas condiciones de prueba, lo que sugiere que la aceleración por GPU resulta más útil en la fase de procesamiento del prompt que en la generación secuencial de tokens.
También intenté configurar llama.cpp para usar la NPU Intel AI Boost, pero la configuración era bastante complicada y requería varias dependencias adicionales. Para no introducir cambios innecesarios en el entorno del sistema, opté por pasarme a Intel OpenVINO. Creé un entorno virtual de Python, instalé los paquetes necesarios y detecté correctamente los tres dispositivos: CPU, GPU y NPU.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
python3 -m venv ~/openvino-env source ~/openvino-env/bin/activate pip install --upgrade pip pip install openvino sudo apt install -y \ build-essential \ cmake \ ninja-build \ libcurl4-openssl-dev \ libtbb12 \ ocl-icd-opencl-dev \ opencl-headers \ opencl-clhpp-headers \ Intel-opencl-icd python -m pip install \ "optimum-intel[openvino]" \ nncf \ transformers |
Una vez instalado todo, utilicé un sencillo script de Python generado por ChatGPT para comprobar si OpenVINO detectaba los dispositivos de procesamiento disponibles. El script se ejecutó sin problemas y confirmó que se podía acceder a la CPU, la GPU y la NPU desde el entorno de Python.
|
1 2 3 4 5 |
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents$ python llama_openvino/test_openvino.py Available OpenVINO devices: CPU: Intel(R) Core(TM) Ultra 7 256V GPU: Intel(R) Arc(TM) Graphics (iGPU) NPU: Intel(R) AI Boost |
Después pedí a ChatGPT otro script sencillo de Python para medir el rendimiento de inferencia de LLM con OpenVINO GenAI. El modelo más pequeño, TinyLlama, alcanzó unos 22-30 tokens/s, con un tiempo hasta el primer token (TTFT) de 0,5-0,7 segundos.
|
1 2 3 4 |
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama_openvino$ python test_rum_llm_openvino.py TTFT: 523.9 ms TPOT: 44.7 ms/token Throughput: 22.4 tokens/s |
Por su parte, el modelo más grande Qwen2.5 7B fue bastante más lento, con unos 5-8 tokens/s y un TTFT de aproximadamente 4-7,6 segundos.
|
1 2 3 4 |
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama_openvino$ python test_rum_llm_openvino.py TTFT: 4590.5 ms TPOT: 155.7 ms/token Throughput: 6.4 tokens/s |
En conjunto, las pruebas confirmaron que el LattePanda Mu Ultra puede ejecutar LLM locales con su CPU, su GPU integrada y su NPU. La GPU aportó una aceleración notable en el procesamiento del prompt, mientras que la NPU gestionó correctamente la inferencia de LLM a través de OpenVINO.
YOLO26 en el kit de desarrollo LattePanda Mu Ultra
Rendimiento de inferencia de YOLO26 (solo forward)
Creé un entorno virtual de Python aparte para probar los modelos YOLO26 con OpenVINO.
|
1 2 3 4 |
python3 -m venv venv_yolo26 source venv_yolo26/bin/activate python -m pip install --upgrade pip python -m pip install opencv-python "openvino==2026.2.0" "ultralytics[export-openvino]" numpy |
Pedí a ChatGPT otro script de Python para medir el rendimiento de inferencia de YOLO26 con OpenVINO. Probé tres modelos (YOLO26n, YOLO26s y YOLO26m) en CPU, GPU y NPU. Cada modelo se exportó en formato FP16 con una resolución de entrada fija de 640 × 640 píxeles. El siguiente código muestra la función principal de la prueba, que mide la latencia de inferencia y calcula los FPS equivalentes.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
# Warm up the device before timing for _ in range(warmup): request.infer() # Measure inference latency times_ms = np.empty(iterations, dtype=np.float64) for i in range(iterations): start = time.perf_counter_ns() request.infer() times_ms[i] = (time.perf_counter_ns() - start) * 1e-6 # Calculate average latency and equivalent FPS mean_ms = float(times_ms.mean()) equiv_fps = 1000.0 / mean_ms |
Las pruebas incluyeron 50 ejecuciones de calentamiento y 500 iteraciones cronometradas con entradas sintéticas para medir la latencia de inferencia y los FPS equivalentes, sin contar el procesamiento de la cámara ni el posprocesamiento. El siguiente gráfico compara los resultados entre los tres dispositivos y los tres modelos.
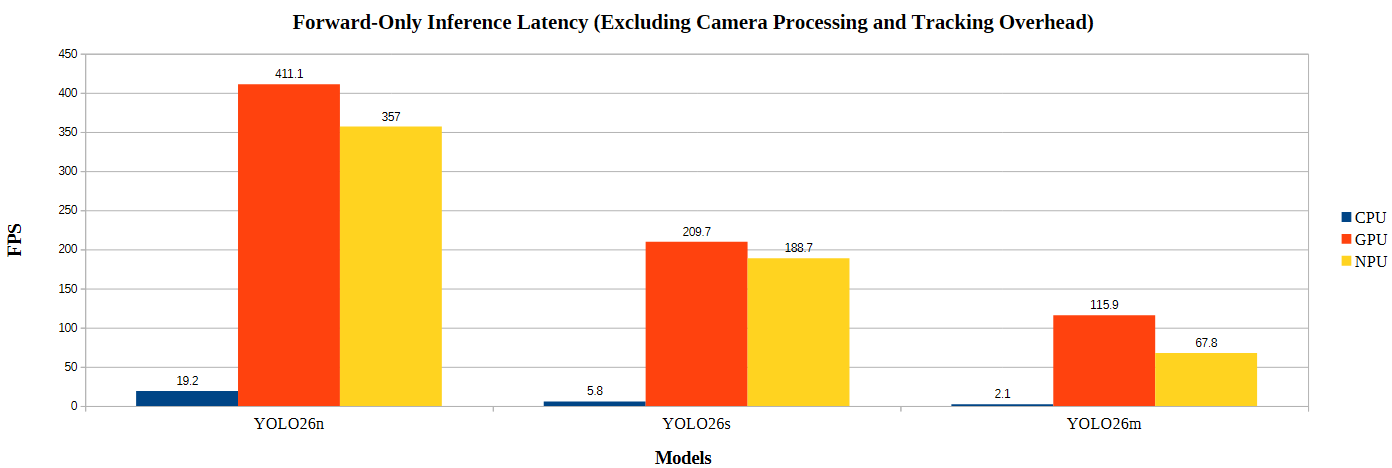
Los resultados fueron impresionantes. La GPU Intel Arc alcanzó 411, 210 y 116 FPS con los tres modelos, mientras que la NPU ofreció 357, 189 y 68 FPS respectivamente. La CPU fue bastante más lenta: 19,2, 5,8 y 2,1 FPS. Curiosamente, la NPU superó el rendimiento anunciado por el fabricante con los modelos YOLO26n y YOLO26s, alcanzando el 152 % y el 119 % respectivamente. Estos resultados ponen de manifiesto la sólida capacidad de aceleración de IA del dispositivo, aunque los valores de FPS corresponden únicamente a la inferencia.
Seguimiento en tiempo real con YOLO26 y BoT-SORT usando una cámara web
A continuación probé la detección de objetos YOLO26 en tiempo real con seguimiento BoT-SORT, usando una cámara USB y OpenVINO en CPU, GPU y NPU. La prueba de solo forward, que excluye el procesamiento de la cámara y el coste del seguimiento, mostró un rendimiento algo inferior al de las pruebas anteriores. Por ejemplo, YOLO26n alcanzó 18,7, 362,5 y 321,6 FPS en CPU, GPU y NPU respectivamente, frente a 19,2, 411,1 y 357,0 FPS en las pruebas previas.
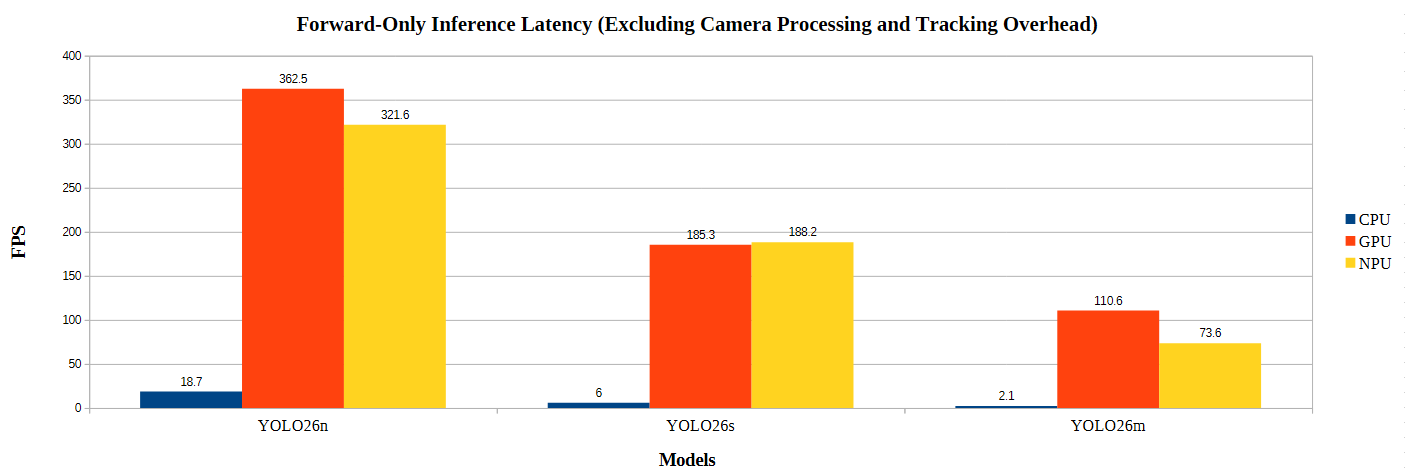
La siguiente figura muestra el rendimiento de las pruebas completas en tiempo real con cámara web, incluida la detección de objetos YOLO26, el seguimiento BoT-SORT y el dibujo de la interfaz. En la CPU, YOLO26n alcanzó unos 48,5 FPS, mientras que YOLO26s y YOLO26m bajaron a 6,2 y 2,3 FPS respectivamente. Al pasar a la GPU o a la NPU el rendimiento mejoró mucho: por ejemplo, YOLO26s subió de 6,2 FPS en CPU a 145,1 FPS en GPU.
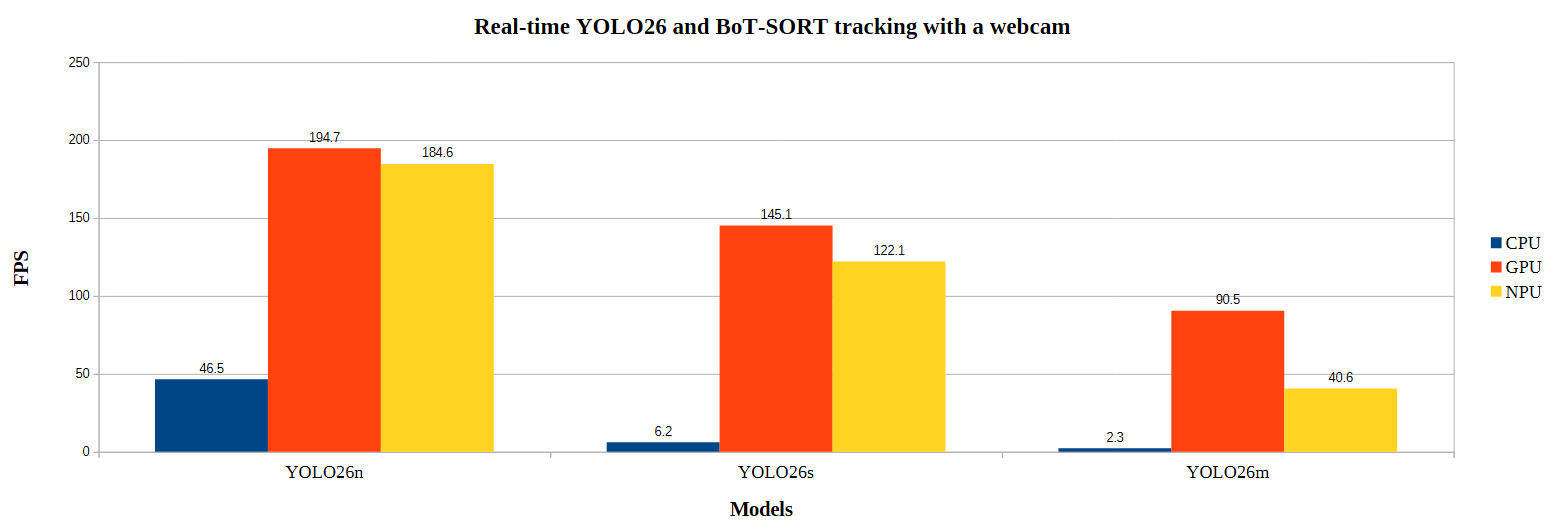
Conviene señalar que el entorno de pruebas no estaba tan controlado como en una investigación formal, por lo que los resultados pueden variar ligeramente. Aun así, las pruebas repetidas mostraron tendencias similares. Además, los valores de FPS de esta sección y de la anterior son FPS equivalentes, no velocidades de fotogramas reales en vivo. En la práctica, la mayoría de las pruebas con GPU y NPU se ejecutaron a unos 10 FPS, probablemente limitadas por mi cámara web USB de bajo coste y por otras tareas de procesamiento. En CPU, YOLO26n también rondó los 10 FPS, mientras que YOLO26s y YOLO26m bajaron a 5,4 y 2,2 FPS respectivamente.
Estimación de mapas de profundidad con Depth Anything V2
A continuación probé la estimación de profundidad de vídeo en tiempo real con Depth Anything V2 en otro entorno de Python. Después pedí a ChatGPT un script sencillo de Python que usara una cámara USB como entrada de vídeo en directo, con NumPy y OpenCV para procesar y mostrar el vídeo. Para esta prueba rápida utilicé el modelo V2-Base, de unos 97,5 MB. El script funcionó sin problemas y alcanzó unos impresionantes 25-30 FPS con la aceleración por GPU activada.
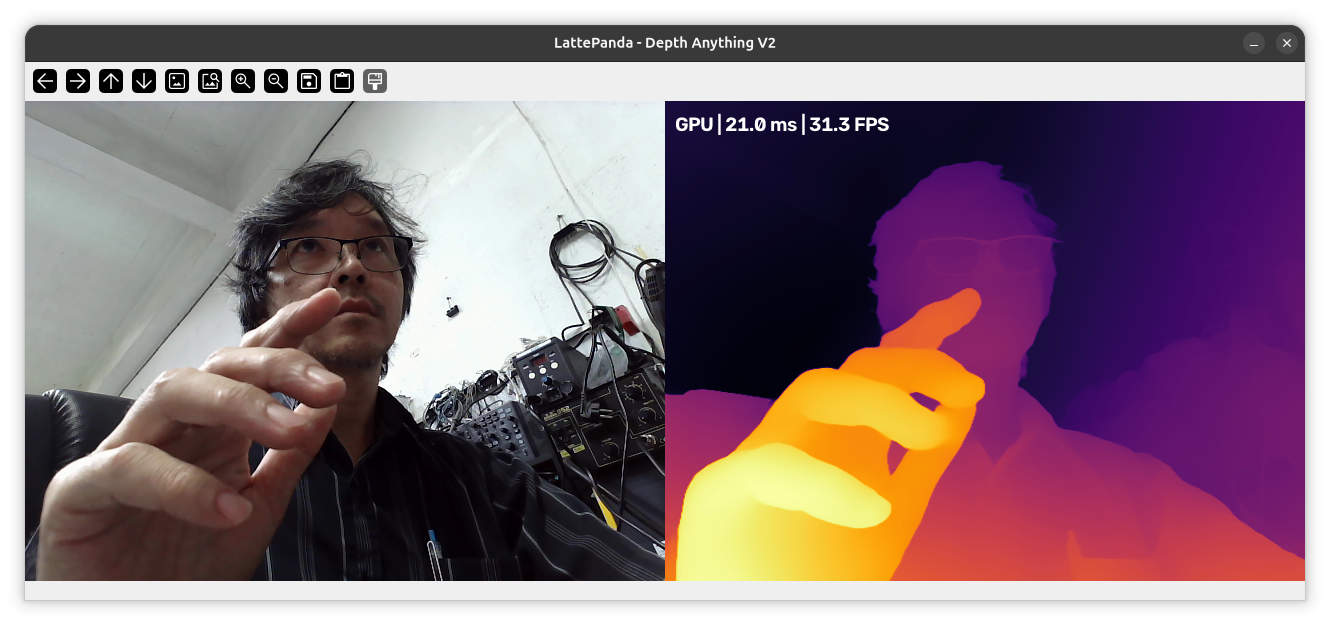
Aquí tienes un vídeo breve que muestra la estimación de profundidad en tiempo real en un entorno exterior.
Aplicación de demostración: ajuste de vídeo en tiempo real con gestos de la mano
Para terminar, preparé la aplicación de demostración de este análisis combinando la detección de objetos YOLOv26 con el seguimiento de gestos de la mano de MediaPipe y la detección de puntos faciales y corporales. La aplicación también permite ajustar la imagen de la cámara web en tiempo real mediante gestos. Sigue ambas manos a la vez: la izquierda controla el tono y la saturación, y la derecha ajusta el contraste y el brillo. Al juntar el pulgar y el índice, el usuario activa los controles, mueve la mano para ajustar la imagen y separa los dedos para fijar los valores.
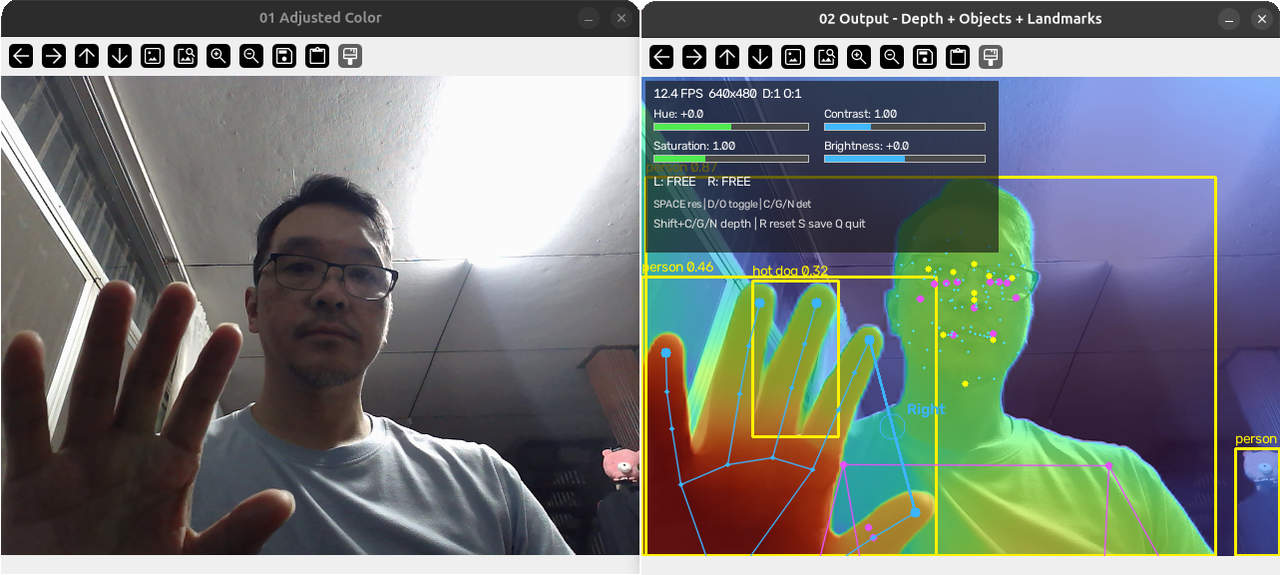
Aquí tienes un vídeo breve en el que se ve la aplicación funcionando en tiempo real. En general, se comportó bien en la resolución predeterminada de 640 × 480, con unos 28-30 FPS. Sin embargo, el rendimiento bajó a unos 10 FPS en 1280 × 720 y a 5 FPS en 1920 × 1080 debido al mayor volumen de procesamiento.
Si te interesa, puedes encontrar el código de Python (generado por IA) en GitHub.
Conclusión
En general, estoy muy satisfecho con el rendimiento del LattePanda Mu Ultra. El montaje del hardware fue sencillo y la instalación del sistema operativo y de los controladores resultó relativamente fácil. Aunque algunas instrucciones de instalación eran algo confusas, la mayoría de las dificultades que encontré estaban relacionadas con software externo y con la compatibilidad de Linux, no con el propio módulo. La CPU, la GPU y la NPU se comportaron bien en todas mis pruebas, lo que convierte al LattePanda Mu Ultra en una opción interesante para aplicaciones de IA en el dispositivo. Como investigador, este módulo compacto me resulta especialmente atractivo, sobre todo porque ahora mismo busco un ordenador pequeño capaz de ejecutar LLM locales y otras aplicaciones de IA.
Por último, quiero dar las gracias a DFRobot por facilitar los productos para este análisis. El kit de desarrollo LattePanda Mu Ultra 256V que he analizado se puede comprar por 733 dólares en DFRobot. Incluye el módulo, la placa portadora mini y el disipador activo. El módulo por separado cuesta 699,00 dólares con la CPU Core Ultra 7 256V, o 599 dólares con la CPU Core Ultra 5 225V.
Traducido del artículo en inglés «LattePanda Mu Ultra Review – An Intel Core Ultra 7 256V AI Compute Module tested on Ubuntu 26.04» de Kumpee Teeravech.

Publicaciones traducidas automáticamente


